ELF文件中动态链接的过程
前言
本文先介绍静态链接和动态链接的差异,再结合 PLT/GOT 讲解动态库函数的调用过程。Linux 桌面和服务器上的很多程序使用动态链接,本文也以它为重点。最初的学习资料见参考课程。[1]
适用范围:下面主要讨论 Linux、glibc 和 x86 的传统 PLT 延迟绑定机制,实际调试截图来自 x86-64(LP64,指针为 8 字节)。部分流程图采用 i386 的 32 位写法,相关差异会单独标注;其他架构、启用 IBT 的 PLT,以及 -fno-plt 等编译方式,不能直接套用这里的指令和偏移。
静态和动态链接文件的差异
以 Linux 的 ELF 可执行文件为例,可以按库的链接方式区分:
- 静态链接:在链接阶段,从静态库(通常是
.a归档)中选取所需的目标文件并链接进可执行文件,并非复制整个库的全部函数。完全静态链接的程序,启动时不需要动态链接器加载这些共享库;它仍然依赖操作系统,程序也可能显式使用dlopen等运行时加载机制。 - 动态链接:可执行文件保留自己的代码,同时记录共享库依赖、动态符号和重定位信息。运行时由动态链接器(下文统称
ld.so)加载共享库并完成必要的重定位;部分函数地址可以延迟到首次调用时解析。
同一个程序也可以混合链接静态库和共享库。
动态链接的好处是:
- 多个进程可以共享同一个
.so文件的只读代码页,减少物理内存占用;可写数据通常是各进程私有的,并不是整个库实例都共享。 - 多个程序复用同一份库文件,通常可以减少整体磁盘占用。
- 在 ABI 和符号版本兼容的前提下,可以更新共享库而不重新链接每个程序;已运行的进程通常仍使用原有映射,需要重启才会使用新版库。
编译后文件的差异
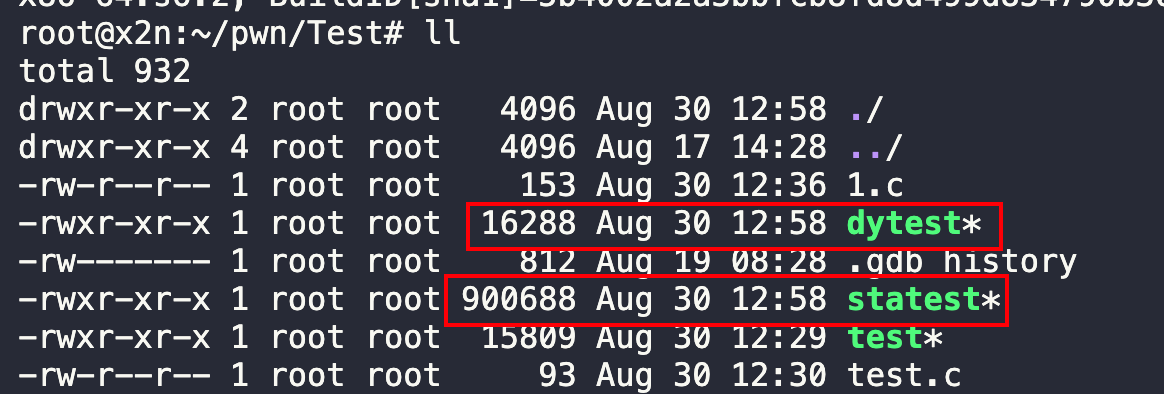
对于相同的源程序和相近的构建选项,静态链接生成的可执行文件通常比动态链接版本大,因为它包含链接进来的库代码和数据。动态链接版本通常不包含共享库中这些函数的实现,但仍有动态链接元数据和跳转代码的开销。文件大小也受调试信息、优化和裁剪选项影响。
同样的文件1.c文件:
静态编译:
1 | gcc -fno-pie -no-pie -static -o statest 1.c |
动态编译:
1 | gcc -fno-pie -no-pie -o dytest 1.c |
区别
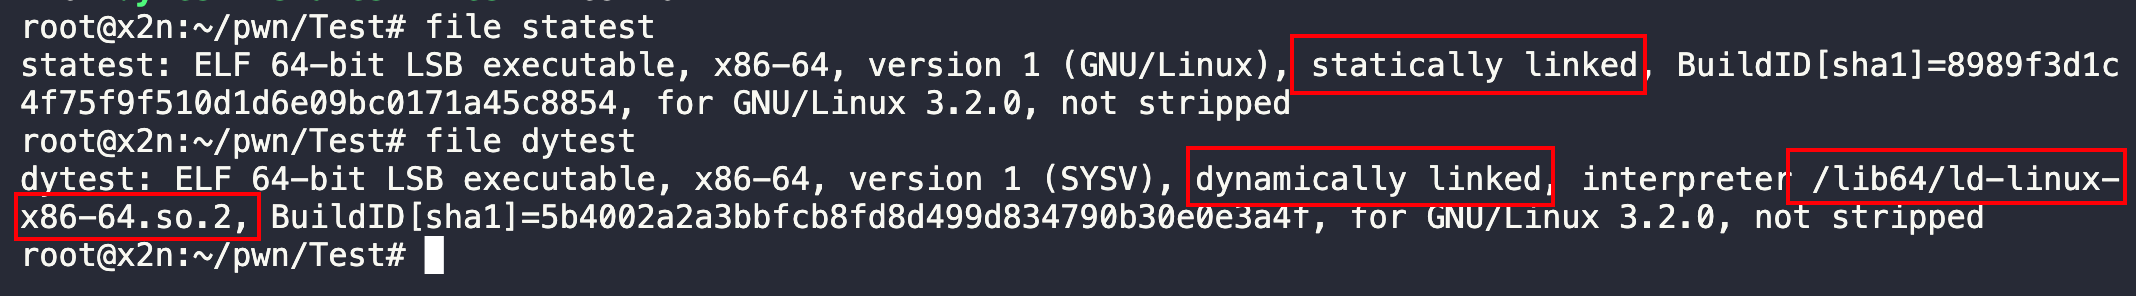
静态的文件是明显比动态的大的。
动态链接的大致过程
可执行文件如何调用动态库函数?
流程大概分 编译期 和 运行期 两个阶段。
(1)编译/链接阶段
- 源代码中调用库函数(如
printf("hello\n");)。 - 编译器编译时,并没有把
printf的实现放进来,而是生成一个 符号引用。 - 静态链接器(如
ld)读取目标文件和共享库的符号信息,完成当前可以确定的地址和重定位,并把需要运行时处理的引用记录在动态符号表、动态重定位表中;依赖库通常记录为DT_NEEDED条目。 - 对本文这种传统外部函数调用,链接器生成 PLT(Procedure Linkage Table) 跳板和对应的 GOT(Global Offset Table) 槽位,并把调用点链接到 PLT。不是编译器独自生成最终的 PLT/GOT。
📌 举例:
在 main 里调用 printf,最终生成的调用指令通常会指向 printf@plt。编译器可能把简单的 printf 调用优化成 puts,因此后面的示例用 -fno-builtin-printf 保留 printf 调用。
(2)运行阶段
运行时由动态链接器负责,流程是这样的:
- 加载 ELF
- Linux 内核处理
execve时,根据程序头中的PT_LOAD映射可执行文件的可加载段,并从PT_INTERP取得解释器路径(例如/lib64/ld-linux-x86-64.so.2)。 - 内核映射解释器并把控制权交给它。解析
DT_NEEDED、查找和加载共享库由动态链接器负责,不是内核遍历.dynamic去寻找依赖库。运行时定位这些信息主要靠程序头和动态条目,不依赖节名。[2]
- Linux 内核处理
- 动态链接器查找库
- 动态链接器读取主程序以及依赖库的动态信息,递归加载所需共享库,并把它们的可加载段映射到当前进程。
- glibc 下,对于不含
/的依赖名,搜索会涉及DT_RPATH(没有DT_RUNPATH时)、LD_LIBRARY_PATH、DT_RUNPATH、/etc/ld.so.cache和系统默认目录;RUNPATH只用于该对象的直接依赖,安全执行模式还会限制环境变量。实际 libc 依赖名通常是libc.so.6。[3]
- 符号解析与重定位
- 动态链接器在启动阶段完成必须提前处理的重定位。启用延迟绑定时,可把部分 PLT 函数重定位推迟到调用时处理。
- 首次经过尚未绑定的 PLT 表项调用某函数时,PLT 中的间接跳转读取对应 GOT 槽位;在传统 x86 PLT 中,该槽位初始指向这个 PLT 表项里的解析准备指令。
- 这段代码提供重定位参数,再经
PLT0进入动态链接器的 resolver。动态链接器按符号名、版本和查找作用域寻找定义,并把解析结果写回该 GOT 槽位。 - 解析器随后转入目标函数,完成这一次调用。后续经过同一个 PLT 表项调用时,直接读取已更新的 GOT 槽位并跳到目标函数。
这种机制称为 Lazy Binding(延迟绑定),可以避免为未调用的 PLT 函数提前完成符号查找,从而减少启动开销。它延迟的是绑定,不是等到第一次调用才加载 DT_NEEDED 中的库。
使用 LD_BIND_NOW=1 ./a.out,或在链接时使用 -Wl,-z,now,会要求提前完成原本可延迟的函数重定位。这里的“提前解析”针对加载对象所需的重定位,并不是遍历所有库中每个导出函数。[3:1]
关键数据结构
- PLT(Procedure Linkage Table):保存一段“跳板”代码,程序调用库函数时跳到这里。
- GOT(Global Offset Table):保存地址等运行时数据,包含用于访问函数、全局变量等的槽位;尚未完成延迟绑定的函数槽位并不是最终函数地址。
- 动态链接器
ld.so:运行时负责加载库、解析符号、做重定位。
动态链接调用printf实际案例
1 |
|
编译:
1 | gcc -O0 -fplt -fno-builtin-printf -Wl,-z,lazy hello.c -o hello |
查看依赖:
1 | ldd hello |
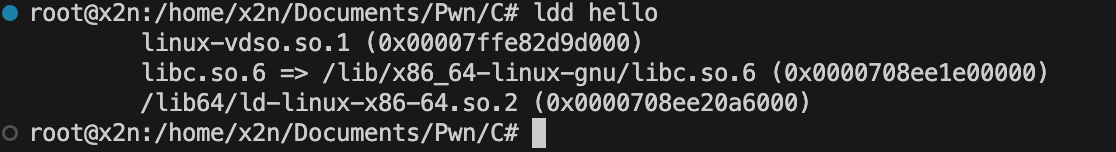
查看反汇编:
1 | objdump -d hello | grep plt |
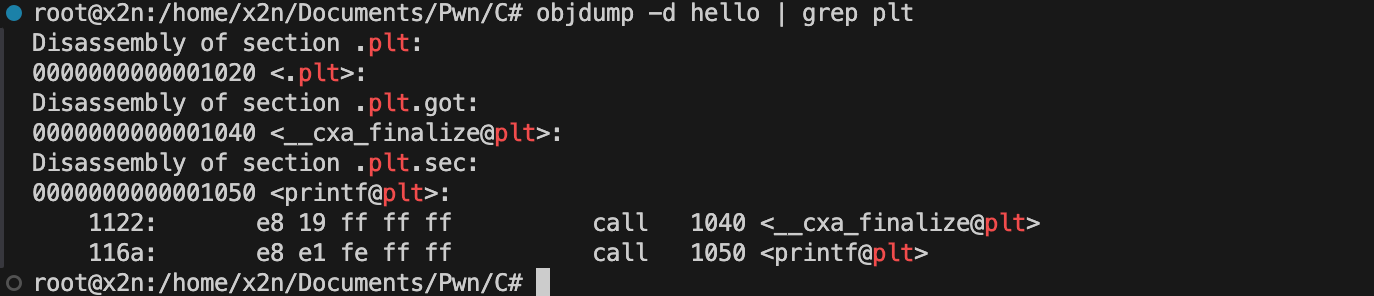
运行时第一次调用 printf:
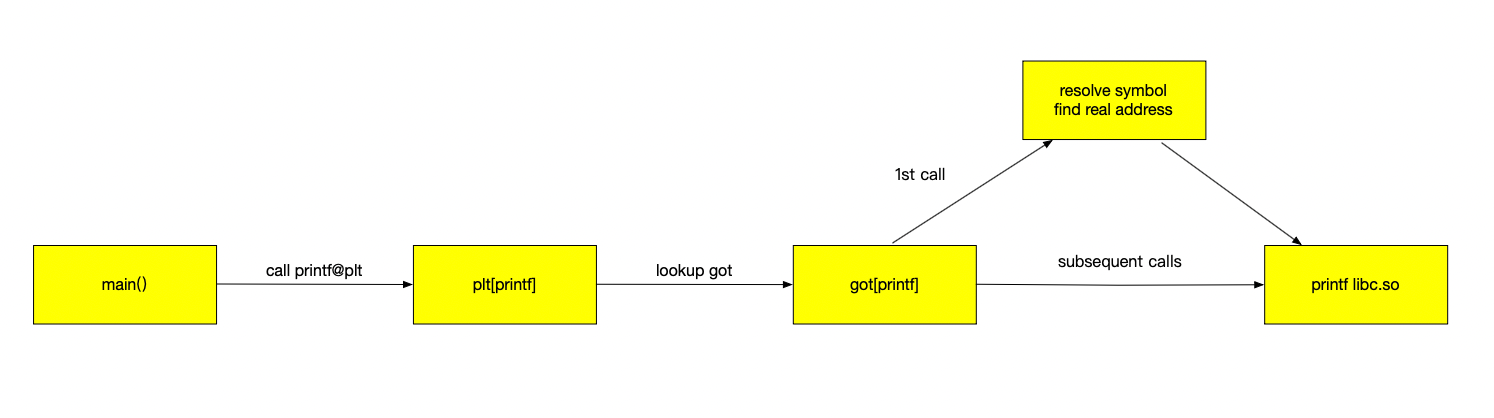
main -> printf@plt。- PLT 读取 GOT 槽位,先跳回 PLT 内的解析准备指令,再经
PLT0进入 resolver。 - resolver 完成符号查找和 GOT 回填,并跳到
printf实现;在没有符号替换等情况时,通常解析到libc.so.6。 - 后续调用仍经过
printf@plt,但其间接跳转已直接指向解析出的函数。
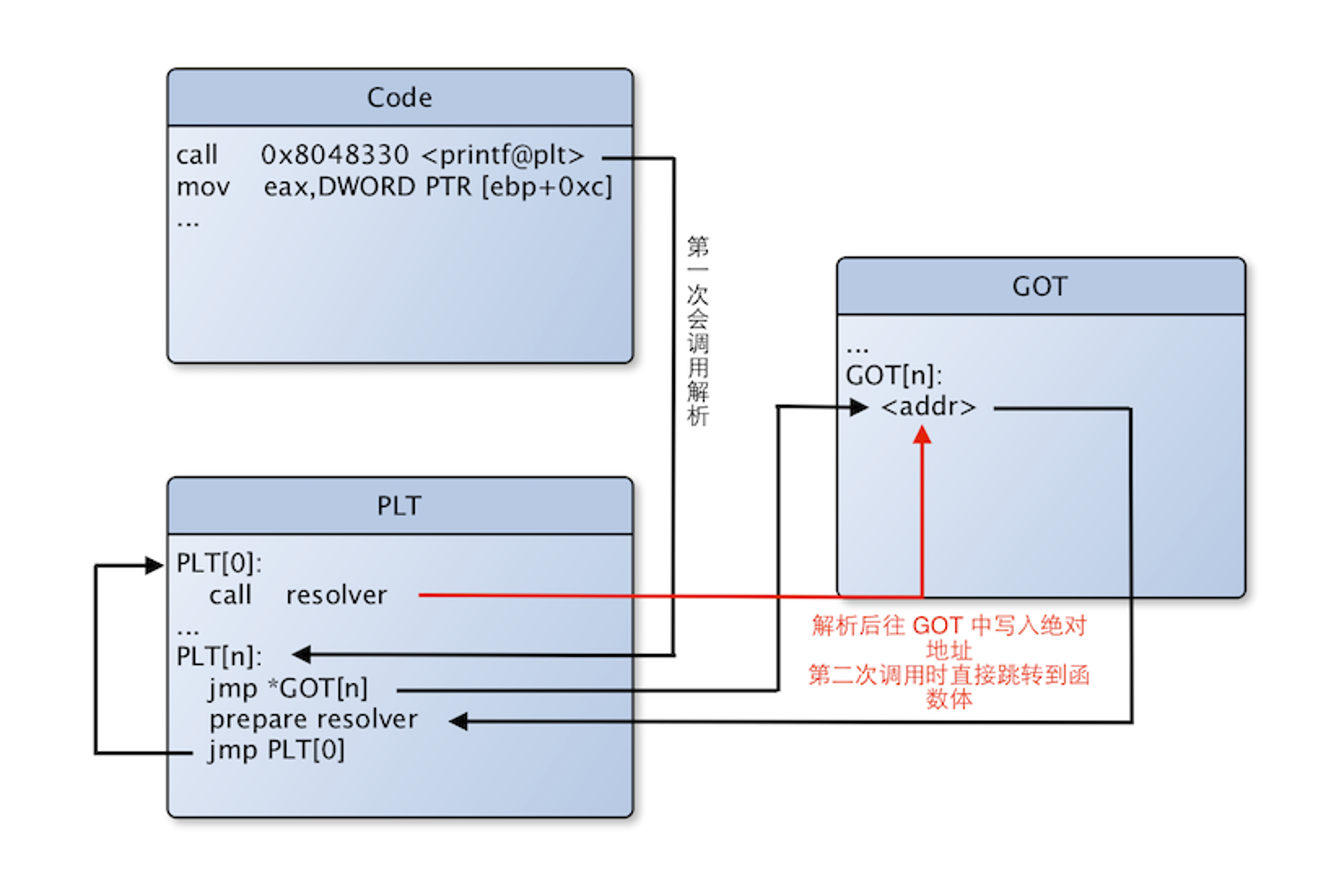
下图是简化的数据流图,省略了 PLT 内部和 PLT0 的准备步骤。GOT 是被读取的数据,图中的箭头不表示 CPU 在 GOT 中执行指令。
总结
动态链接的可执行文件调用库函数的核心机制是:
- 编译和链接时,为本文涉及的共享库函数保留动态引用,并生成 PLT 跳板、GOT 槽位和重定位记录。
- 运行时,动态链接器加载共享库并处理重定位;采用延迟绑定的 PLT 槽位通常在首次调用时更新。
- 完成绑定后,调用点进入 PLT,由 PLT 读取 GOT 中的目标地址并跳转。
PLT 延迟绑定只是动态链接的一种实现路径。例如 -fno-plt 可以生成直接经 GOT 的间接调用,对应的外部函数地址需要在装载时解析;程序内已确定的调用也可以直接跳转。[4]
动态链接过程中相关结构
下面这些结构常用于动态链接,但不能仅凭出现 GOT/PLT 就断定程序一定是动态链接的。例如静态链接程序也可能为位置无关代码或 IFUNC 解析保留相关结构,静态 PIE 也可以包含 .dynamic。判断时应结合 PT_INTERP、DT_NEEDED、文件类型和重定位信息。[5]
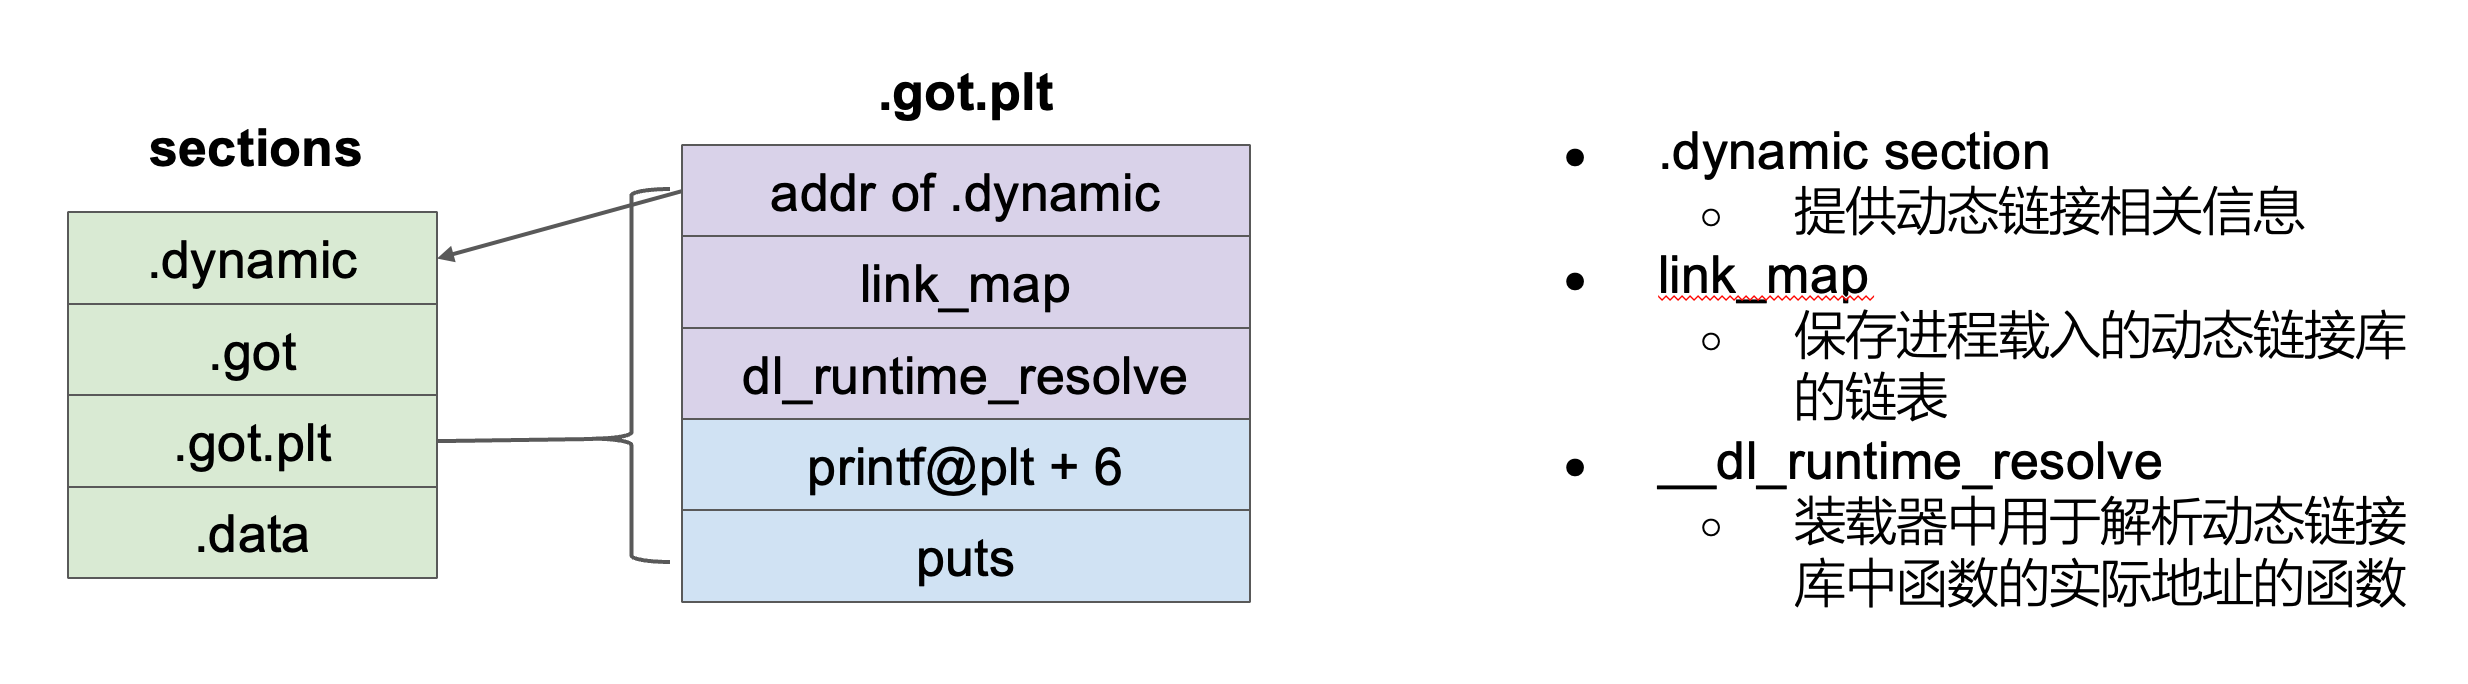
.dynamic section的作用
- 存储动态链接相关的信息
.dynamic包含一系列Elf32_Dyn或Elf64_Dyn结构体,每个结构体称为一个 动态条目(dynamic entry),用来告诉动态链接器如何处理这个 ELF 文件。 - 内容示例(常见的动态条目):
DT_NEEDED:依赖库名称在动态字符串表中的偏移(例如名称libc.so.6)DT_STRTAB:动态字符串表的虚拟地址(通常对应.dynstr)DT_SYMTAB:动态符号表的虚拟地址(通常对应.dynsym)DT_PLTGOT:与 PLT/GOT 有关的地址,含义由架构 ABI 定义;本文传统 x86 布局中用于定位 PLT 使用的 GOTDT_JMPREL/DT_PLTRELSZ/DT_PLTREL:PLT 重定位表的地址、大小,以及采用REL还是RELA格式DT_INIT/DT_FINI:初始化函数、结束函数的地址DT_REL/DT_RELA:其他动态重定位表的地址,另有条目记录其大小和单项大小DT_DEBUG:调试相关的结构(gdb 用)
- 和 GOT/PLT 的关系
.dynamic是节(section),运行时由PT_DYNAMIC程序头定位。动态链接器根据这些动态条目找到符号和重定位信息,并按重定位类型更新目标位置;在本文的 PLT 延迟绑定路径中,更新的是 GOT 槽位,通常不需要改写 PLT 指令。地址类动态条目也不等于文件偏移,运行时解释时还要考虑对象的装载偏移。[2:1]
换句话说:
.dynamic是一张“说明书”,告诉动态链接器要加载哪些库、符号表在哪、重定位信息在哪。- 动态链接器根据
.dynamic提供的这些信息,去修正(fixup).got.plt,使得程序调用外部函数时能找到正确的地址。
这里的“修正”指把解析出的地址写入对应的函数槽位。.dynamic 也服务于其他重定位、初始化和终结处理,并不只用于修正 .got.plt。
.got.plt 的作用
.got.plt 的全称是 Global Offset Table for the Procedure Linkage Table,也就是 PLT 专用的 GOT 表。
从用途上说,.got.plt 是 GOT 机制中供 PLT 使用的部分;从 ELF 节的组织上说,.got 和 .got.plt 通常是两个独立的节,不是嵌套关系。 它们也不属于存放指令的 .plt。具体是否分节、如何命名和排列,取决于链接器及选项。
主要作用
传统 x86 布局下,这里既有供解析器使用的保留槽位,也有每个待绑定函数对应的地址槽位。
-
存放动态链接函数的地址
-
程序调用外部库函数(比如
printf、puts)时,真正的函数地址在编译时是未知的。 -
.got.plt就是用来存放这些函数在运行时的真实地址。
-
-
支持延迟绑定(Lazy Binding)
- 对尚未绑定的函数槽位,传统 x86 PLT 中的初始目标通常是 该函数自己的
func@plt+6,也就是第一条间接跳转之后的准备指令。这个偏移只适用于相应的指令布局,不是所有 PLT 都固定为+6。 - 当第一次调用某个函数时,动态链接器(
ld.so)会解析符号,找到函数在共享库中的实际地址,然后把地址写回.got.plt表项。 - 后续再次调用该函数时,程序直接从
.got.plt里取到真实地址,不需要再调用动态解析器。
- 对尚未绑定的函数槽位,传统 x86 PLT 中的初始目标通常是 该函数自己的
流程示例
以 printf() 调用为例:
- 程序调用
printf@plt→ 进入 PLT 跳板代码。 .plt里第一步会查.got.plt里对应的表项。- 如果尚未绑定,函数槽位先指向 PLT 内的准备指令,经
PLT0才进入动态解析入口;直接保存 resolver 地址的是另一个保留 GOT 槽位。 - 动态链接器解析
printf的地址。
- 如果尚未绑定,函数槽位先指向 PLT 内的准备指令,经
- 动态链接器把解析出的
printf地址写回.got.plt。 - 下次再调用
printf@plt,直接跳转到.got.plt里的真实地址,不再触发解析。
👉 总结一句话:
.got.plt 就是一张“跳转表”,用来存放外部函数在运行时的真实地址。它配合 .plt 实现了 延迟绑定,让程序在第一次调用时解析地址,后面就能直接调用。
动态解析整个动态链接的过程
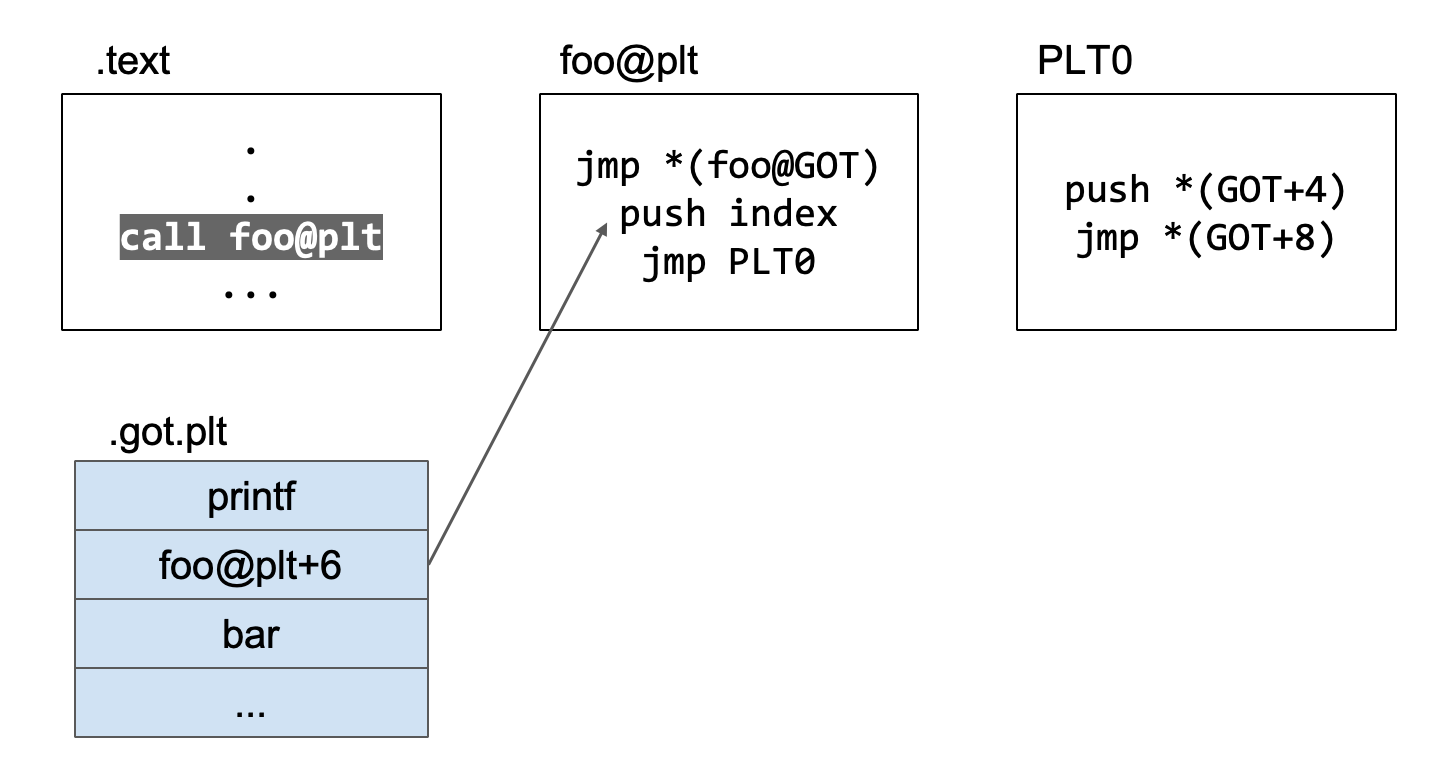
假设代码调用了共享库中的 foo,下面用传统 x86 PLT 图示说明。
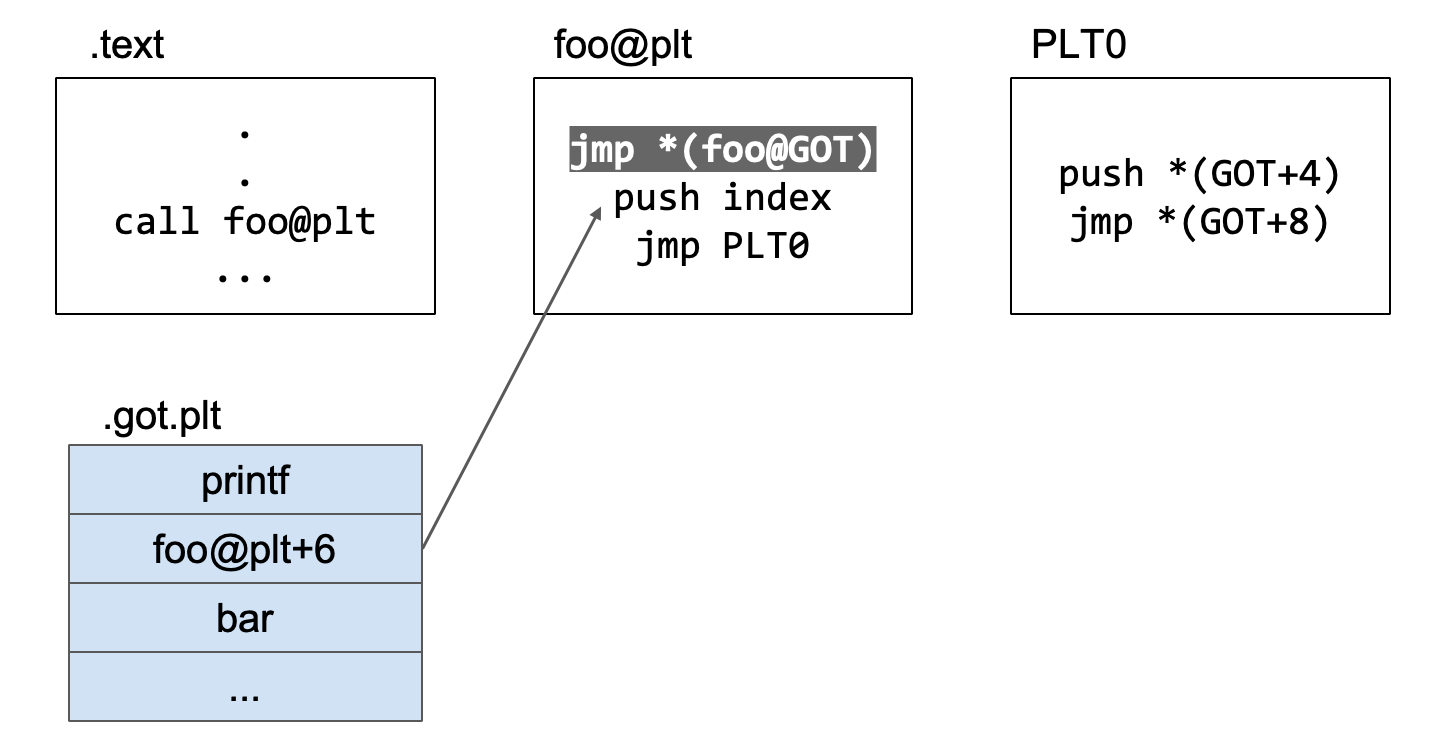
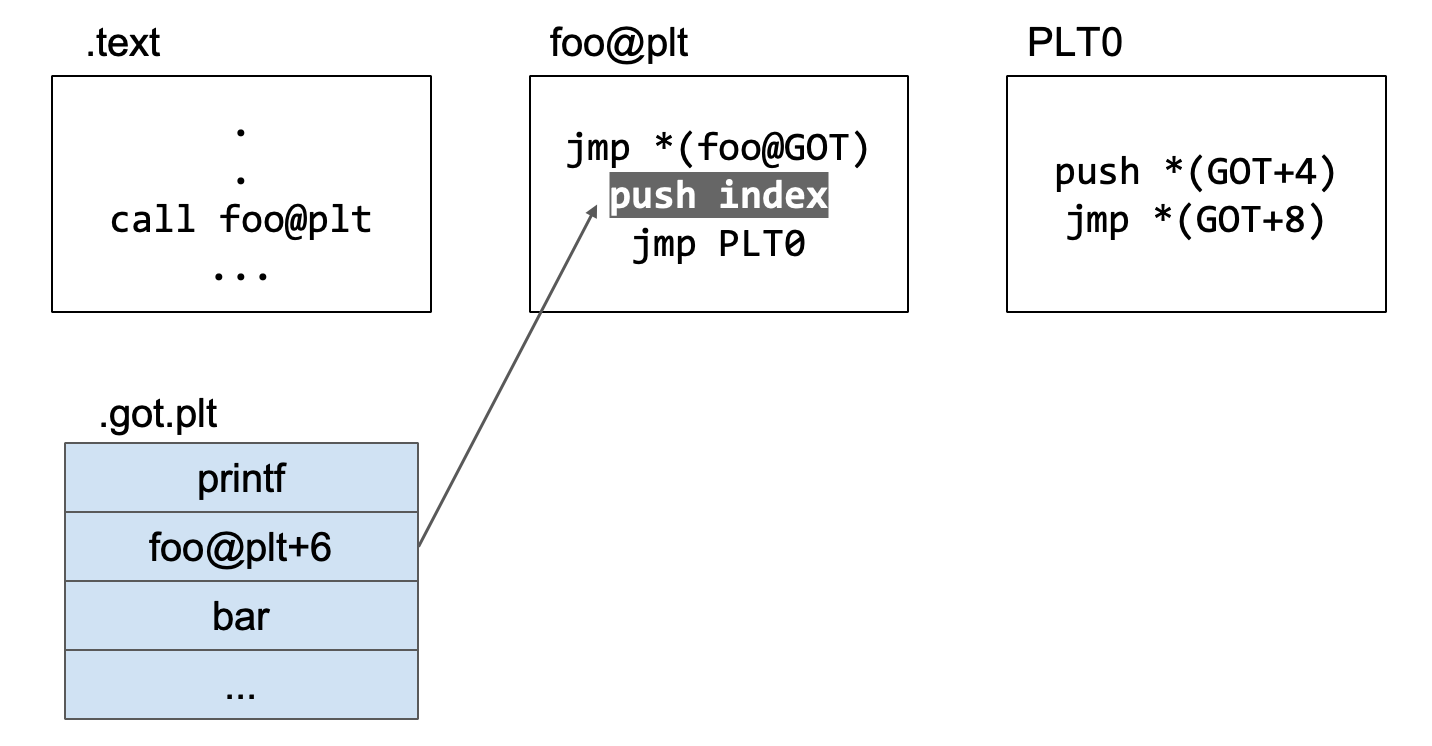
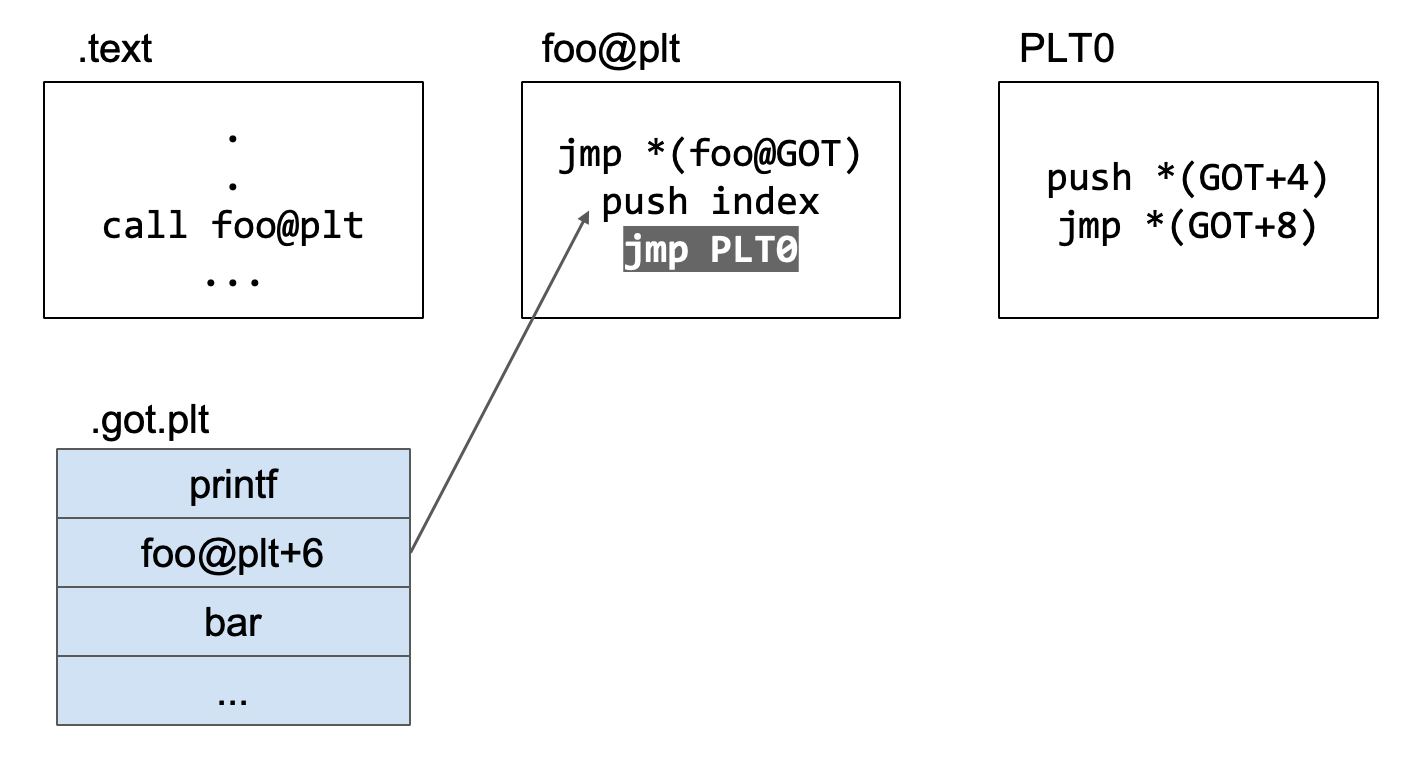
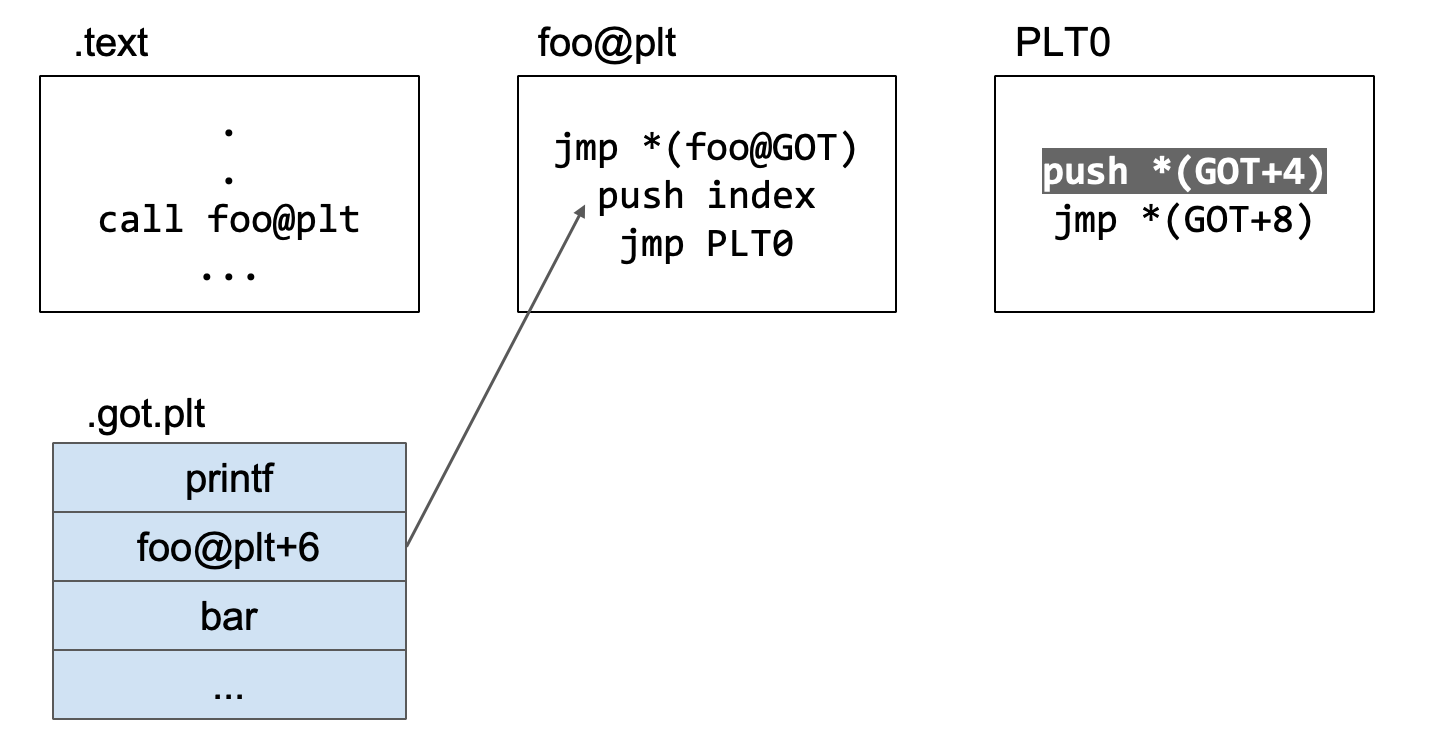
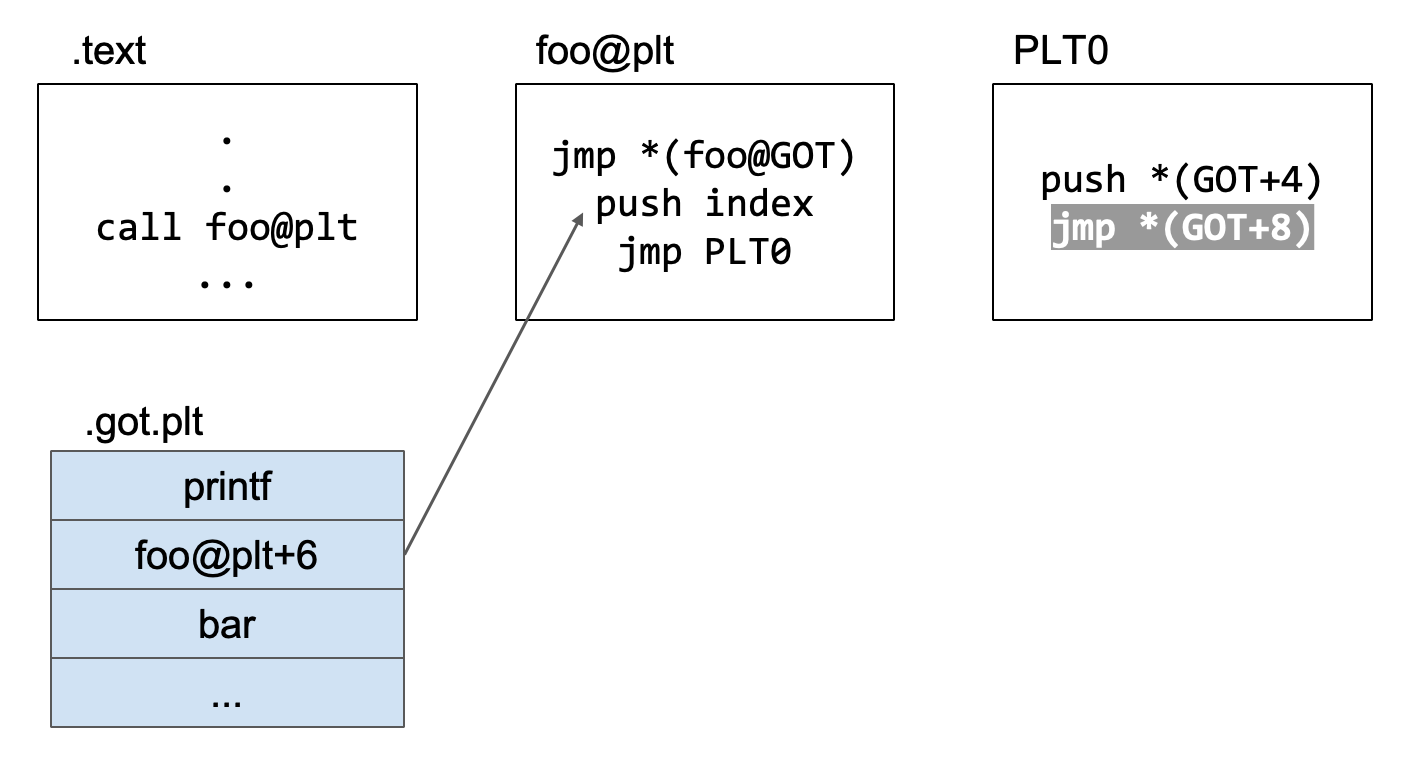
读图约定:旧图中的 GOT+4 / GOT+8 是 i386 的字节偏移,分别表示保留槽位 GOT[1] / GOT[2];x86-64(LP64)中对应 GOT+8 / GOT+16。图中的 push index 统一理解为“压入定位 PLT 重定位记录的参数”,两种架构的编码含义见下文。旧图里的 __dl_runtime_resolve 是泛指解析入口,glibc 常见实际名称是 _dl_runtime_resolve 或带架构后缀的变体。
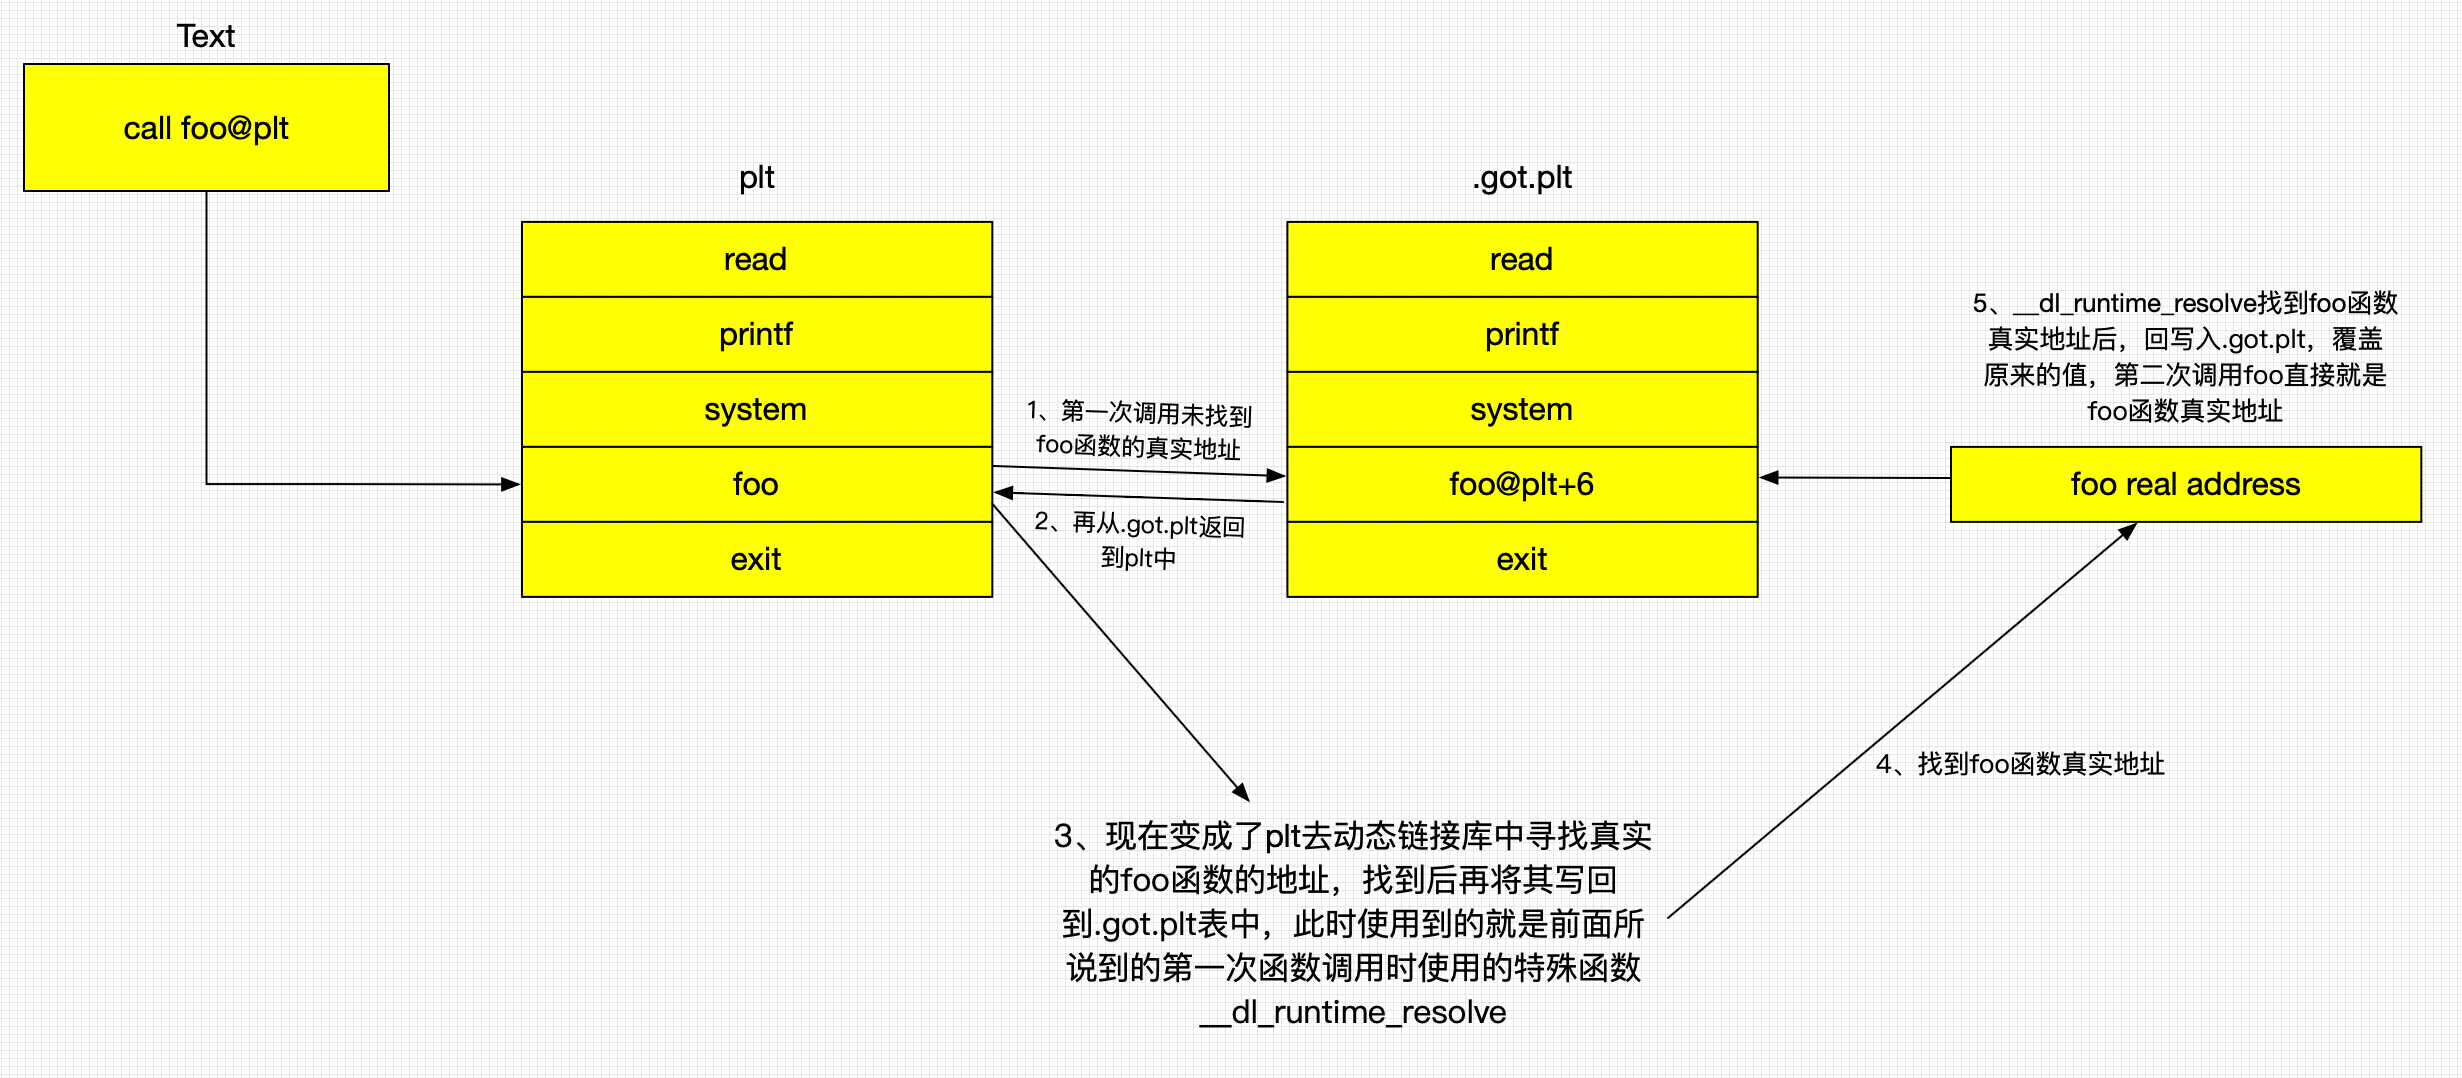
进程首次调用foo
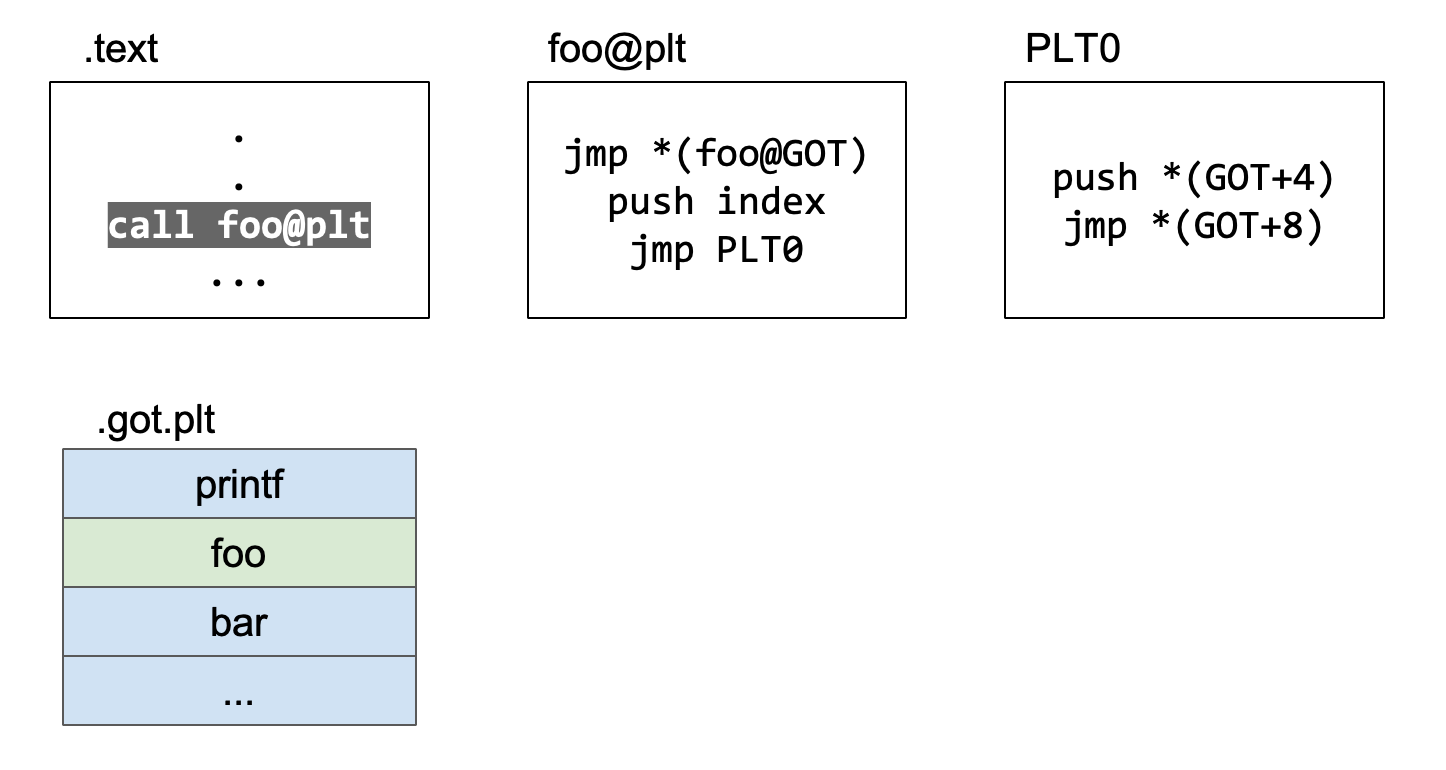
.text 通常存放程序指令,.plt 存放链接器生成的跳板指令;二者是节(section),通常映射进可执行的 PT_LOAD 段(segment)。[6] PLT0 是传统 PLT 的公共解析入口,其核心是压入对象标识并间接跳转到 resolver,后面还可能有填充指令。.got.plt 存放数据,通常映射进可写的加载段;其中部分或全部区域可能在重定位后受 RELRO 保护。
首先是.text代码段调用foo函数。
跳转到.plt中的foo表项
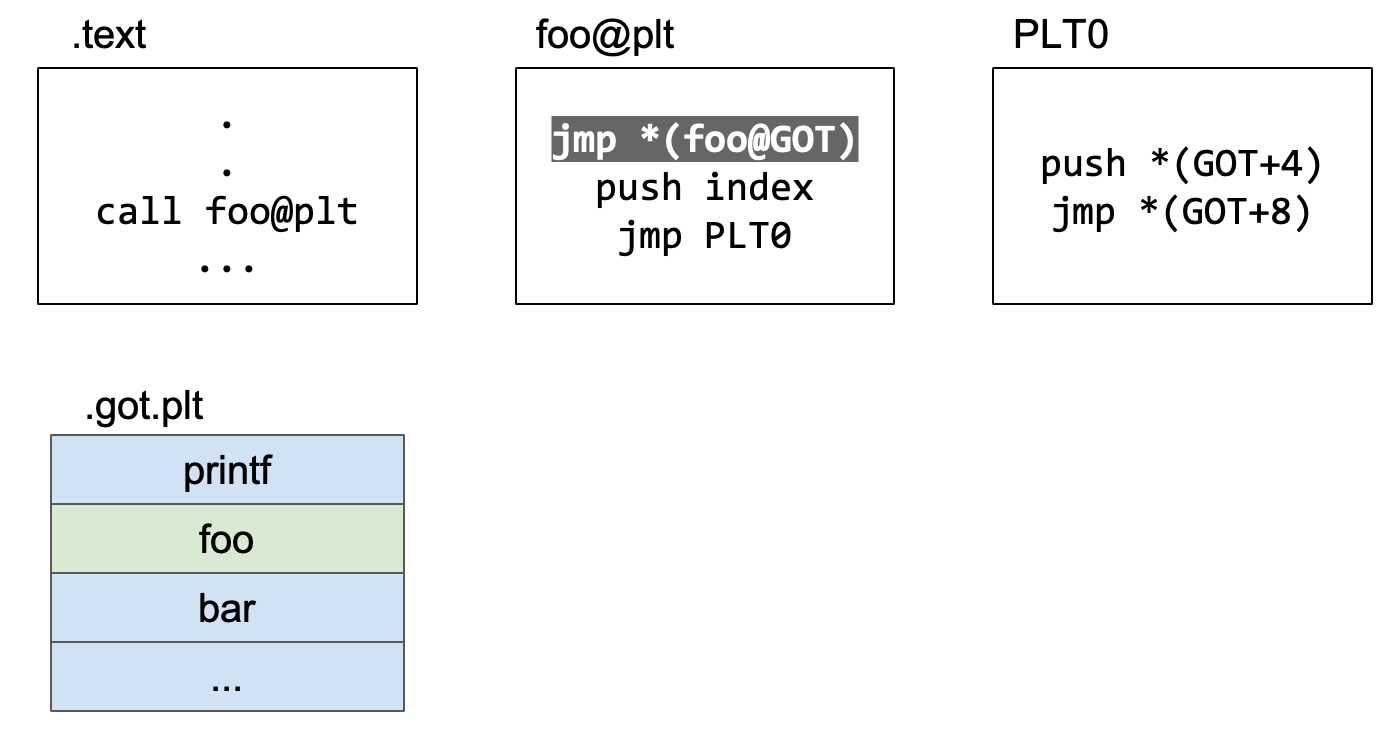
跳转到.plt中的foo表项,.plt中的代码立即跳转到.got.plt中记录的地址。
这里用 jmp *(foo@GOT) 表示一次内存间接跳转:CPU 读取 foo 对应 GOT 槽位里的地址,再跳到该地址,不是跳到 GOT 槽位本身。该写法是示意,真实反汇编会带有架构对应的寻址方式。
.got.plt中记录的地址
但是foo@GOT里面的内容是foo@plt+6,这个是plt表项下面的代码,又跳回到了plt,并且是跳到了jmp的下面的一行代码。
这里的 6 是 6 个字节:在本文采用的传统 PLT 布局中,第一条内存间接 jmp 编码长 6 字节,因此 foo@plt+6 指向后面的 push。其他 PLT 布局可能不同,要以反汇编为准。
回到.plt,解析foo的实际地址
接下来执行的步骤可写为下面的伪汇编。这里把 GOT 当作指针数组,GOT[1] 和 GOT[2] 指保留槽位的内容,避免混淆字节偏移:
1 | push reloc_arg |
首先压入 reloc_arg,它用于定位当前调用对象的 PLT 重定位记录,不是按源代码顺序给外部函数编号。
| 传统 PLT | reloc_arg 的含义 |
GOT[1] / GOT[2] 的字节偏移 |
|---|---|---|
| i386 | .rel.plt 中对应记录的字节偏移;常规 Elf32_Rel 每项 8 字节 |
+4 / +8 |
| x86-64(LP64) | .rela.plt 中对应记录的从 0 开始的索引;常规 Elf64_Rela 每项 24 字节 |
+8 / +16 |
例如第 4 条记录对应 x86-64 的索引 3,或 i386 的字节偏移 3 * 8 = 24。具体数值要核对 readelf -rW 和 PLT 反汇编。x86-64 的转换逻辑可在 glibc 的 reloc_offset 中看到。[7]
再执行jmp PLT0跳转到PLT0。
接下来压入 GOT[1] 中的 link_map 指针。它标识拥有当前 PLT 和重定位表的对象,可能是主程序,也可能是某个共享库,并不是直接指定“提供 foo 的那一个库”。动态链接器借助该对象的动态信息和符号查找作用域解析引用。下图使用 i386 的 GOT+4;后面的 64 位实测中对应 GOT+8。[8]
最后从 GOT[2] 取出解析入口地址并间接跳转。前面准备的 reloc_arg 和 link_map 供解析过程使用。下图是 i386 的 jmp *(GOT+8);x86-64 对应读取 GOT+16 的槽位。
解析foo的真正地址填入.got.plt中
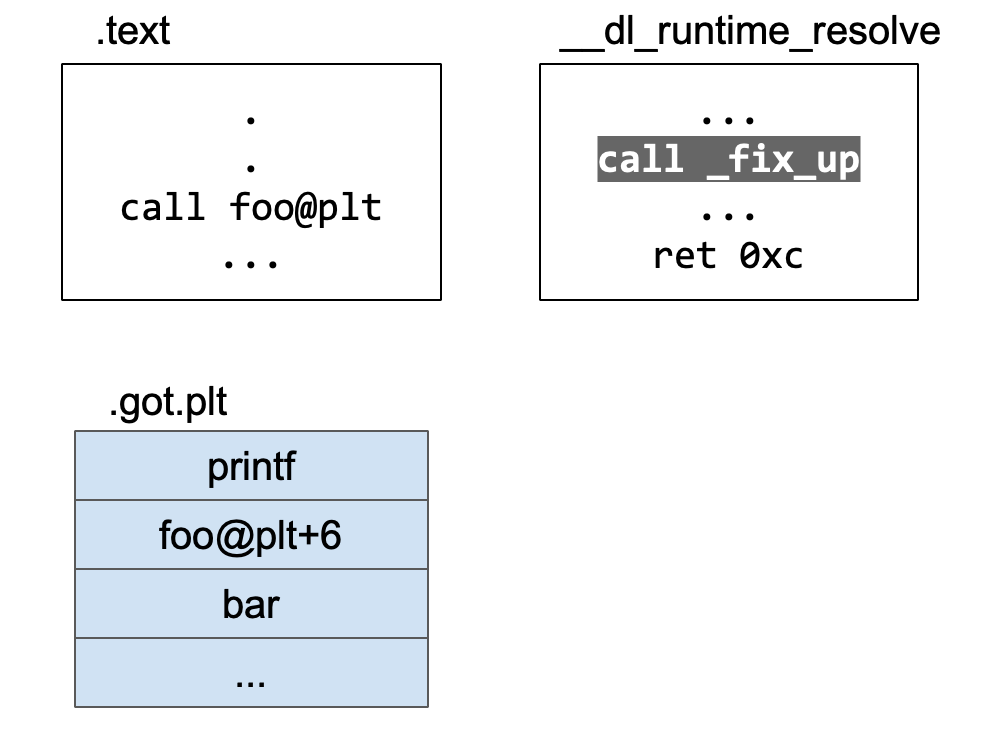
glibc 的运行时解析入口是架构相关的汇编跳板,例如 x86-64 上的 _dl_runtime_resolve_xsavec 等变体。它保存调用现场并调用 _dl_fixup,后者完成符号解析和 GOT 回填。[9]
_dl_fixup 通过 DT_JMPREL 找到对应的重定位记录,从 r_info 取得动态符号表索引,再由符号表和字符串表取得符号名,结合符号版本及查找作用域查找定义。对普通已定义函数,其运行时地址通常由定义对象的装载偏移加上符号值得到;IFUNC 还需要调用其专用 resolver 选择实现。重定位记录的 r_offset 则确定要更新的槽位位置。[9:1]
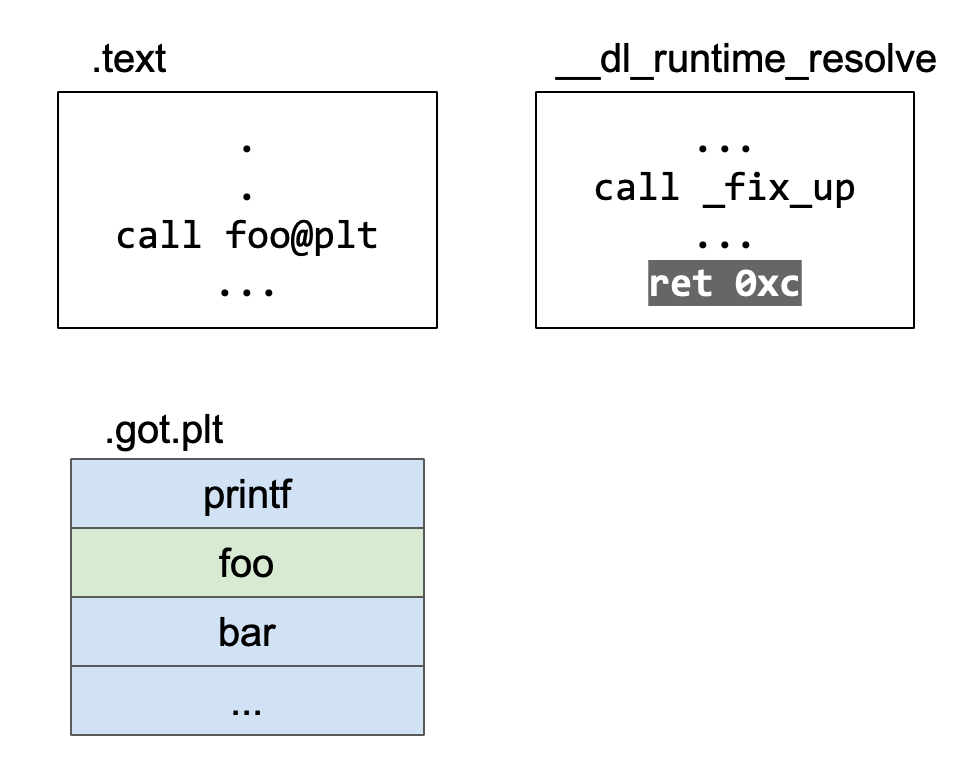
解析完成后,汇编跳板恢复现场并跳入 foo,完成第一次调用本身;foo 返回时回到原调用点之后。若存在 LD_PRELOAD 等符号替换,解析结果可能来自替换对象,不必然是链接时最初想到的那个库。
此后 .got.plt 中保存的是 foo 的真实地址
第二次调用foo
call foo@plt 仍进入 PLT。此时第一条间接跳转读取 GOT 槽位,取得的已经是绑定后的 foo 地址。
CPU 从 PLT 直接跳到 foo,跳过此前的 push、PLT0 和解析器路径。这里“直接”是指跳过解析过程,调用点仍经过 PLT。
整个完整流程总结
下图概括传统延迟绑定的路径。图中 call resolver 是概念示意,本文的 PLT0 实际通过间接 jmp 进入解析入口;GOT 方框表示地址读取或回填。
真实代码演示动态链接的过程
测试的dylink.c代码:
1 |
|
使用以下命令编译成可执行文件。
1 | gcc -O0 -g -fno-pie -no-pie -fplt -fno-builtin -Wl,-z,lazy -fcf-protection=none -o link dylink.c |
这些命令面向 Linux x86-64 的 GCC/GNU 工具链,参数含义如下:
-O0 -g:关闭优化并保留调试信息,便于逐行观察。-fno-pie -no-pie:分别控制代码生成和链接,生成普通非 PIE 可执行文件。主程序通常采用固定链接地址,但这不会关闭整个进程的 ASLR,共享库和栈等仍可随机化。-fplt:采用经过 PLT 的外部调用方式;-fno-builtin避免编译器把示例库函数调用替换或折叠。-Wl,-z,lazy:请求延迟绑定。运行环境中的LD_BIND_NOW仍可能要求提前绑定。-fcf-protection=none:关闭本次编译的控制流保护插桩,不保证整个二进制没有endbr64,也不保证链接器生成传统 PLT。启动文件可能带有相关指令,链接器的-z ibtplt/-z ibt等设置也会影响 PLT。[10]
原实验命令中的 -Wl,--no-as-needed 会让链接器为其后参与链接的共享库保留 DT_NEEDED 条目,即使该库没有满足当前的未定义符号引用;这个例子不需要额外指定它。[11]
先核对实际生成的 ELF:
1 | readelf -hW link # 确认 ELF64、x86-64 和文件类型 |
RELRO 与绑定时机:传统延迟绑定需要相关函数槽位在运行时可写。常说的 Full RELRO 通常由 -Wl,-z,relro,-z,now 实现:先完成绑定,再把相应 GOT 区域设为只读;仅有 -z relro 并不等于所有函数都提前绑定,单独 -z now 也不等于 GOT 已受只读保护。[11:1]
下面保留原实验截图。截图中的具体地址、符号排列和 PLT 布局只属于当时的构建结果,复现时应以自己的输出为准。
可执行文件中的plt和got
使用gdb对编译的可执行文件进行查看,查看plt和got中的内容:
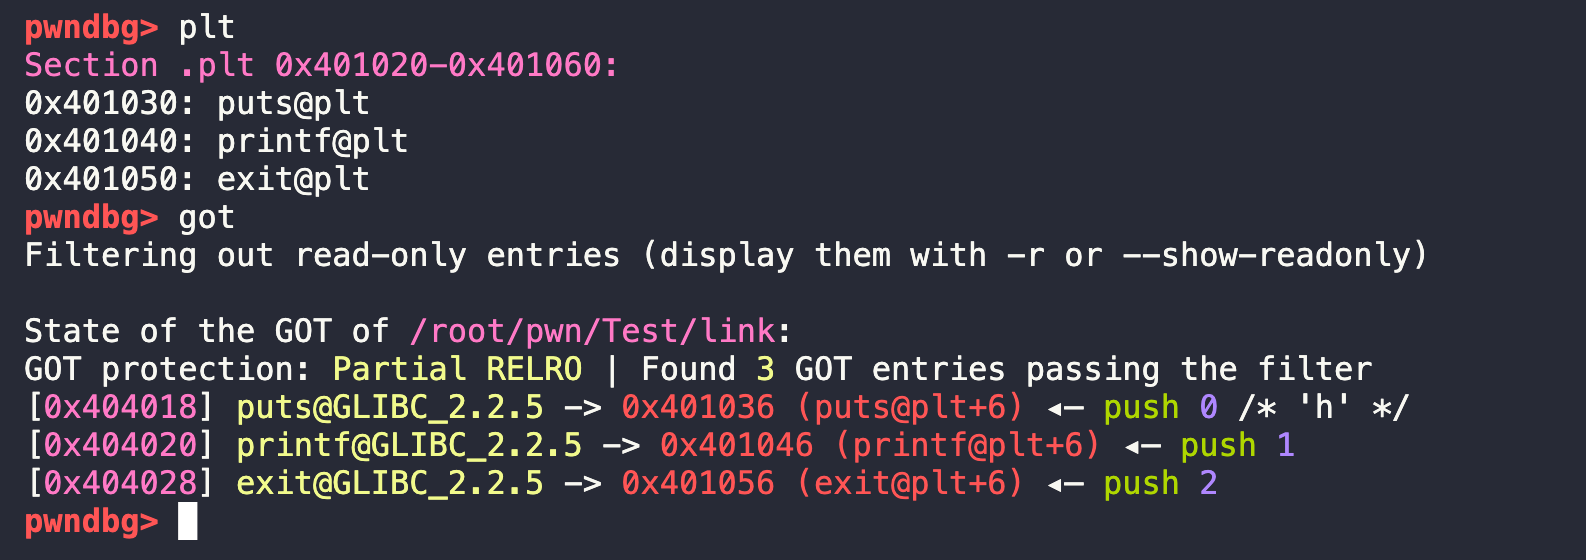
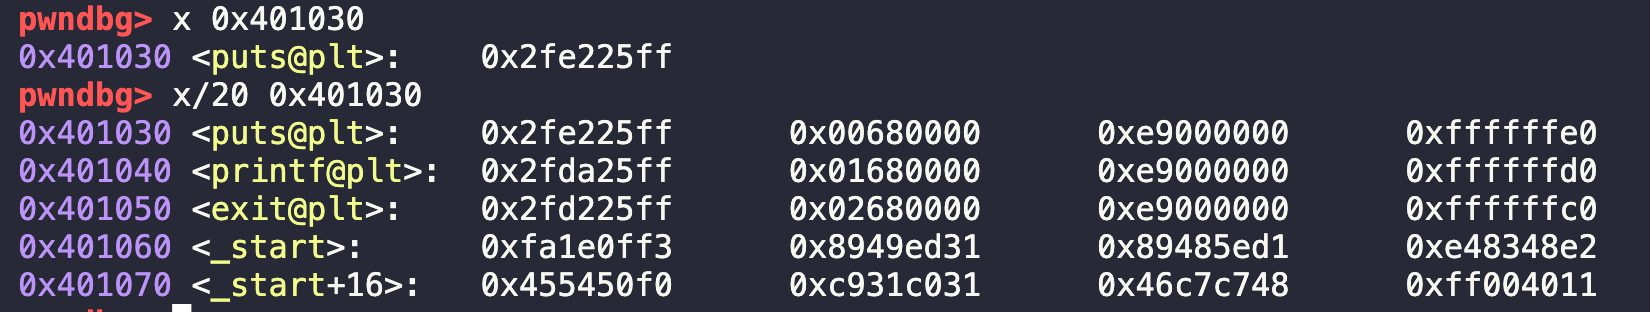
再详细查看 PLT。GDB 的 x/nfu addr 中,n 是读取的单元数量,f 是显示格式,u 是单元大小;省略时会沿用默认值或此前设置。截图中的 x/20 0x401030 使用 4 字节单元,读取 20 个单元,共 80 字节;每行显示 4 个单元才是 16 字节,并不是 x/20 本身规定每行 16 字节。看指令可明确使用 x/12i 0x401030,看一个传统 16 字节 PLT 表项的原始字节可用 x/16bx 0x401030。[12]
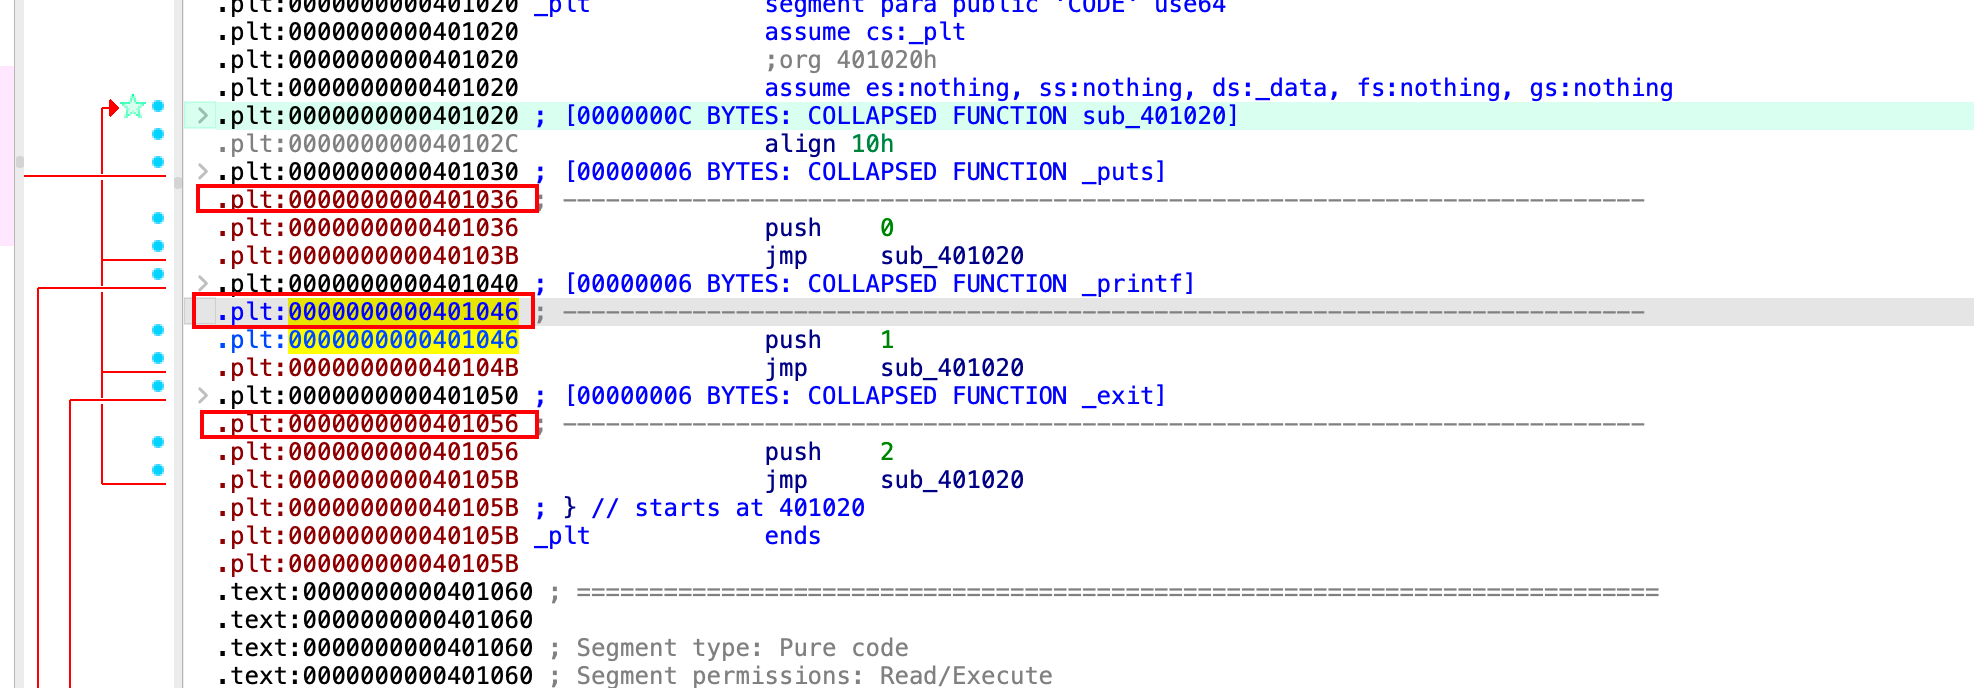
使用 IDA Pro 查看 link,该样本的传统 PLT 表项间距为 16 字节,例如 0x401056 - 0x401046 = 0x10。这里比较的是相邻表项中相同位置的指令地址;16 字节是此布局的大小,不是所有 ELF 的通用规定。这部分是可执行代码。
这里就对应了我们前面说到的汇编代码:
1 | push reloc_index ; 示意:x86-64 中的重定位记录索引 |
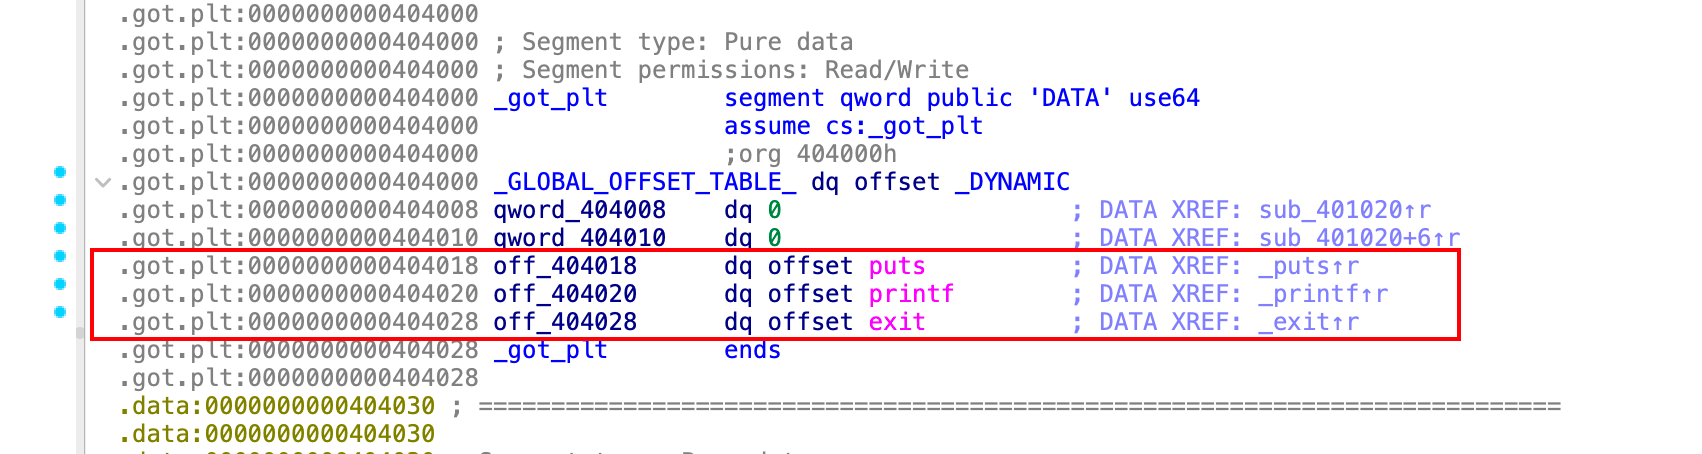
下面是 .got.plt 节,红框标出了 puts、printf 和 exit 的函数槽位。前面还有三个保留槽位:该样本中的首项指向 _DYNAMIC,后两项在装载时可由动态链接器设置为 link_map 和 resolver 地址。
从图中地址可以看出,LP64 下每个 GOT 地址槽位占 8 字节,不是函数代码本身只占 8 字节。IDA 静态查看的是文件初始内容:尚未绑定的函数槽位通常保存相应的 func@plt+6。图中的 dq offset ... 标签不能被当作已经解析出的 libc 运行时地址;后两项保留槽位在文件里也可能还是 0。
gdb动态调试查看.got.plt的变化
调试可执行文件
1 | gdb link |
对于本例,若已经确认启用延迟绑定,且主程序这个 puts PLT 槽位此前未被使用,那么在 main 处它仍指向 puts@plt+6。先用 readelf -rW link 找出槽位地址,再在 GDB 中读取;原截图的 puts 槽位是 0x404018,可用 x/gx 0x404018 查看。若已经是 libc 地址,应先检查 NOW 标志和此前是否发生过绑定,不能仅凭“还没执行到 main 中的 puts”断定它未解析。
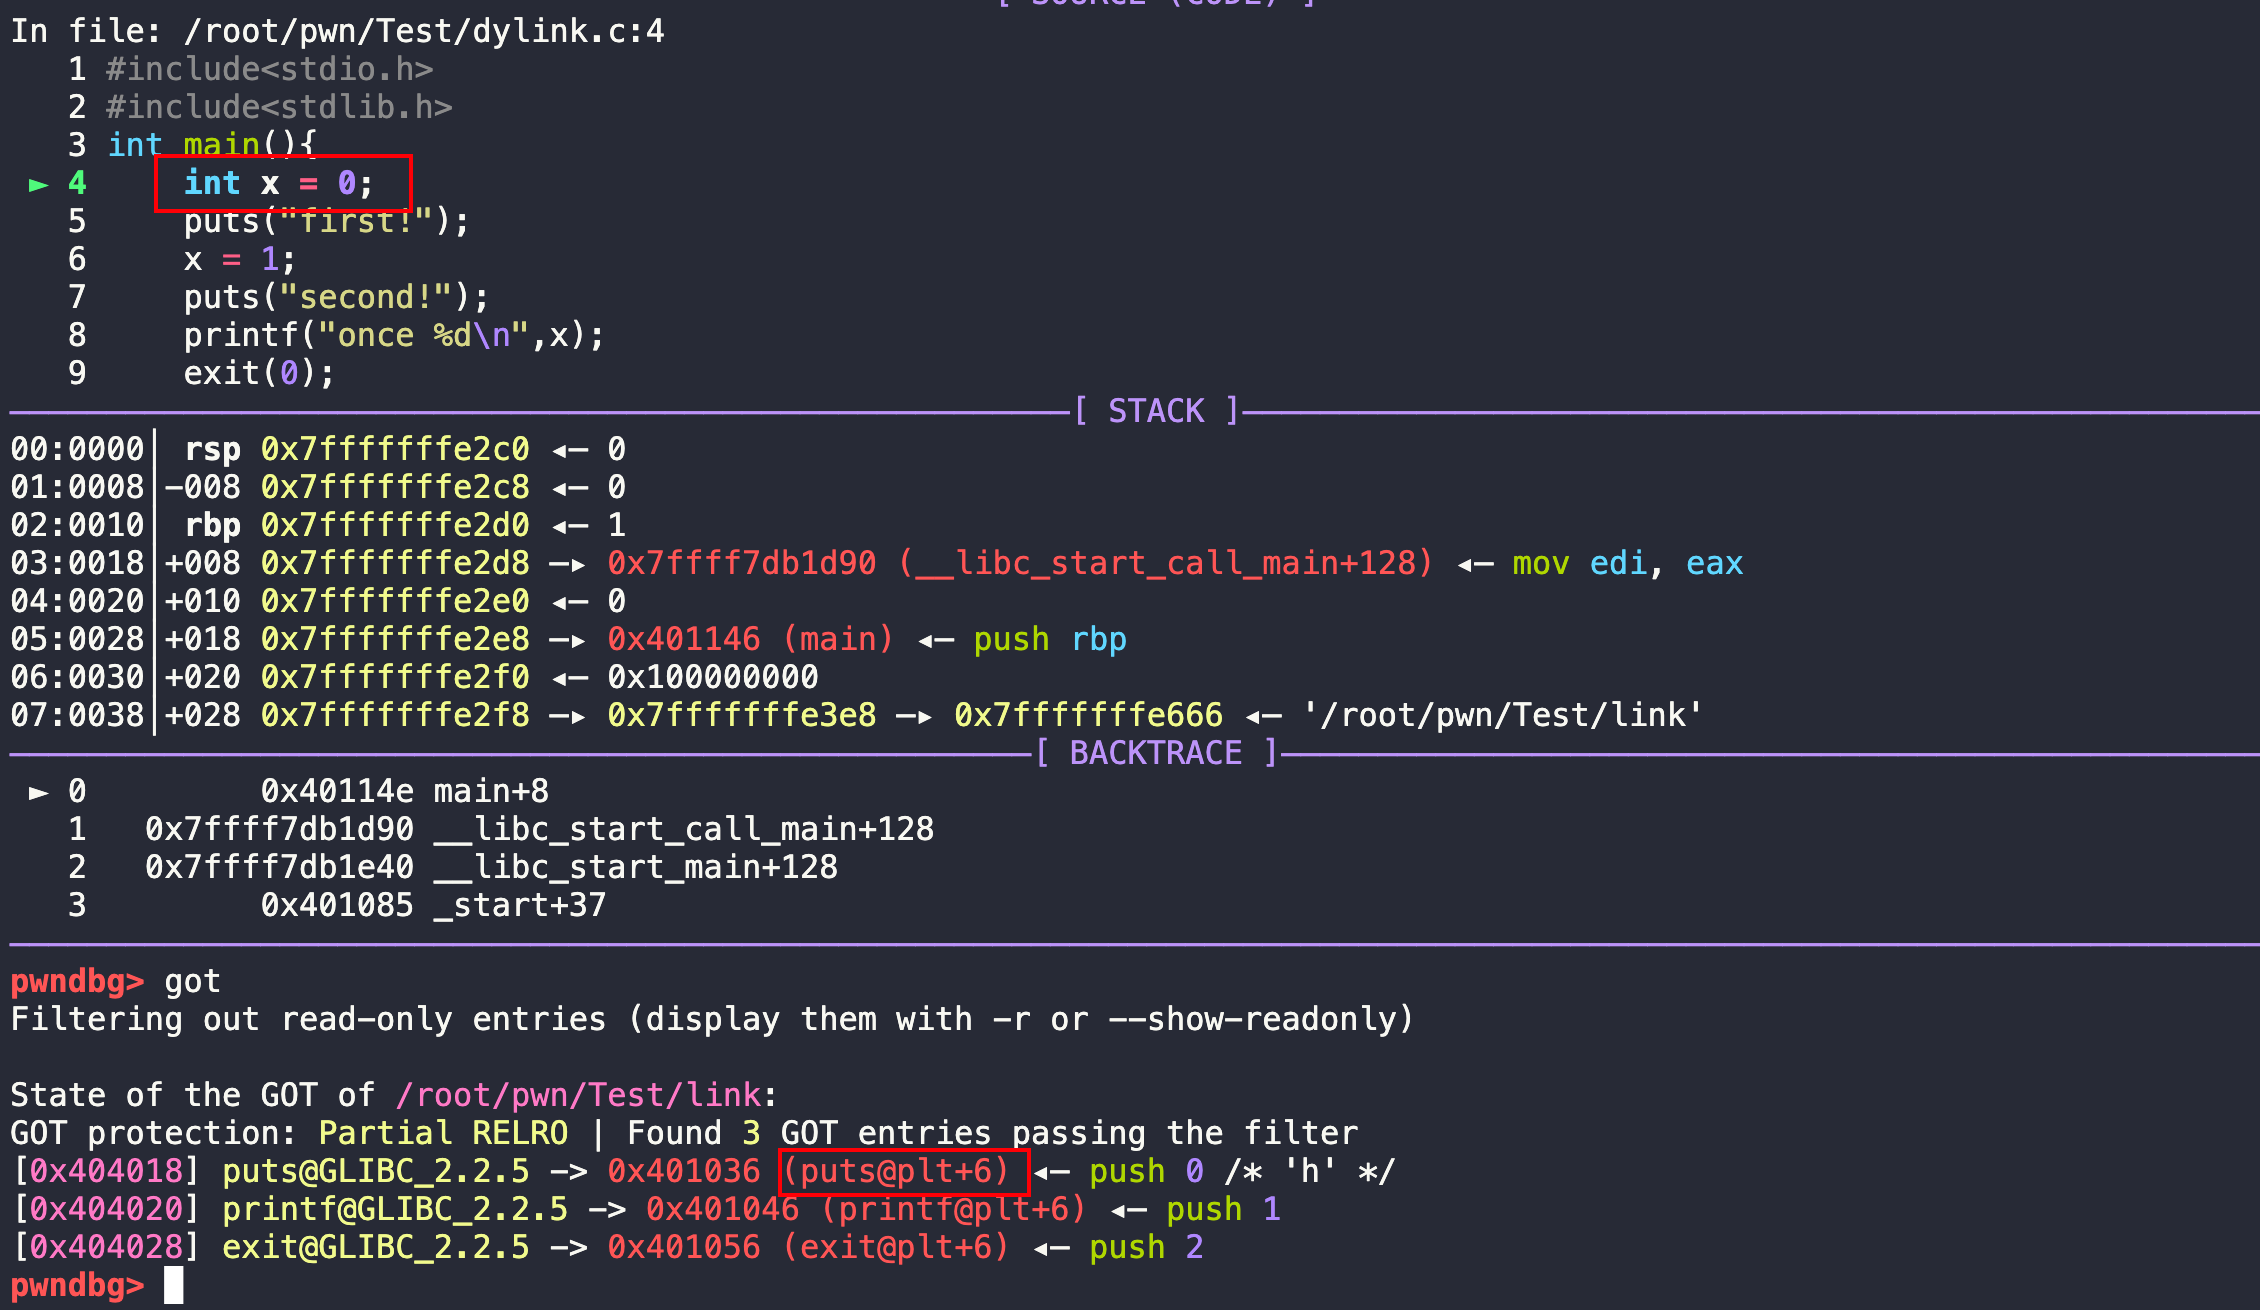
next(缩写 n)按源代码行推进,必要时执行多次,直到越过第一次 puts 调用,再查看同一个 GOT 槽位。常规 glibc 延迟绑定会把解析出的 puts 地址写回该槽位,后续经过这一 PLT 表项的调用读取更新后的地址。若要观察 PLT 内部指令,改用 stepi(si)。
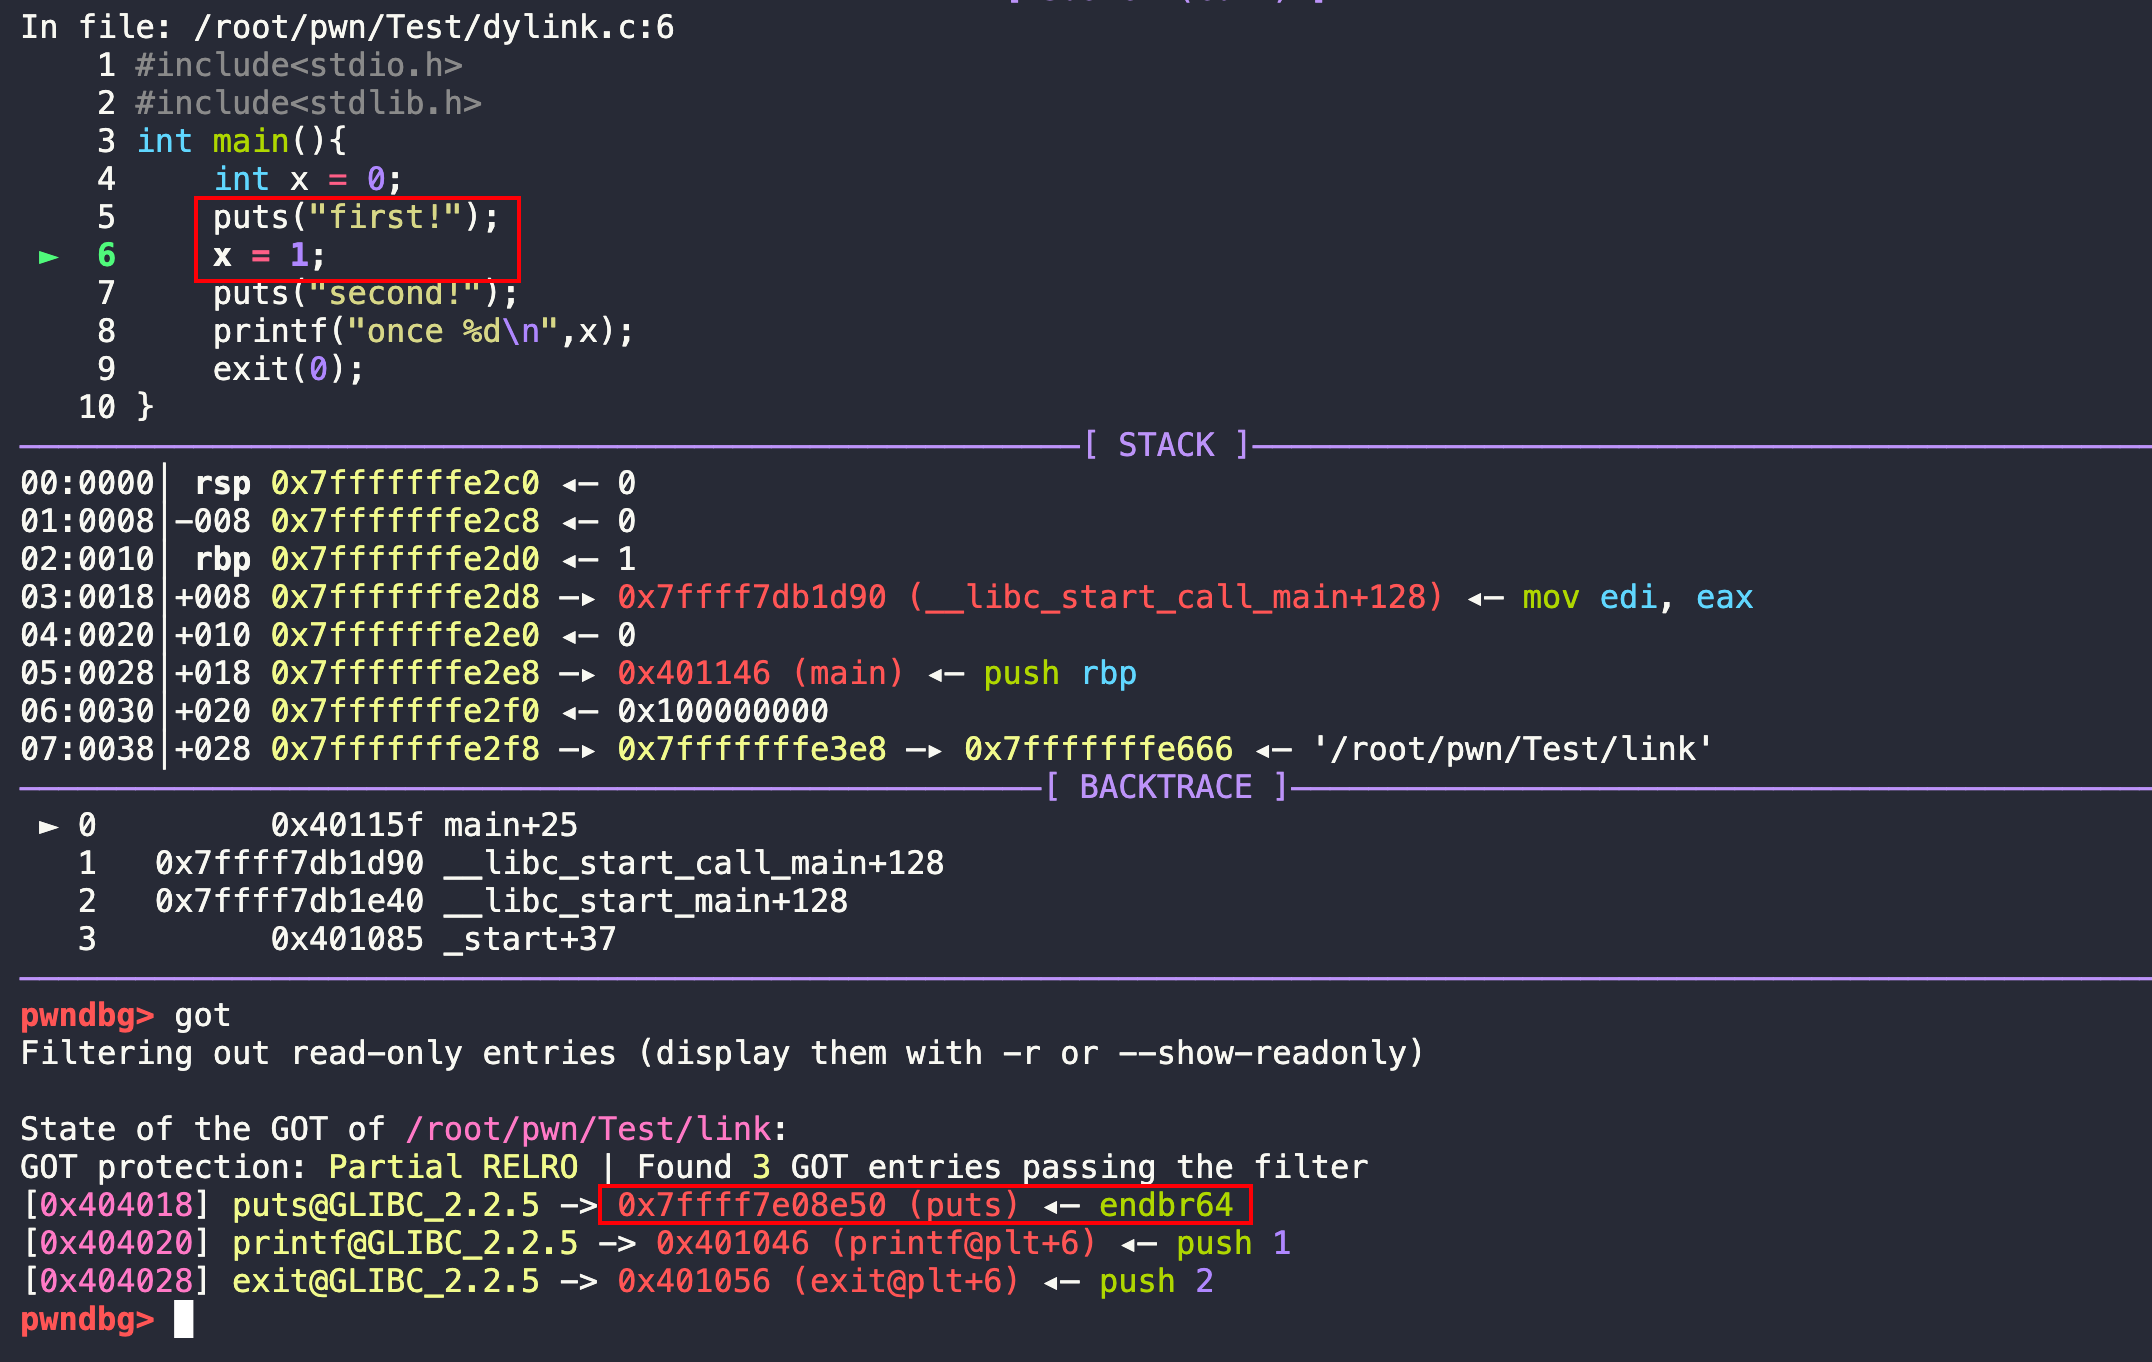
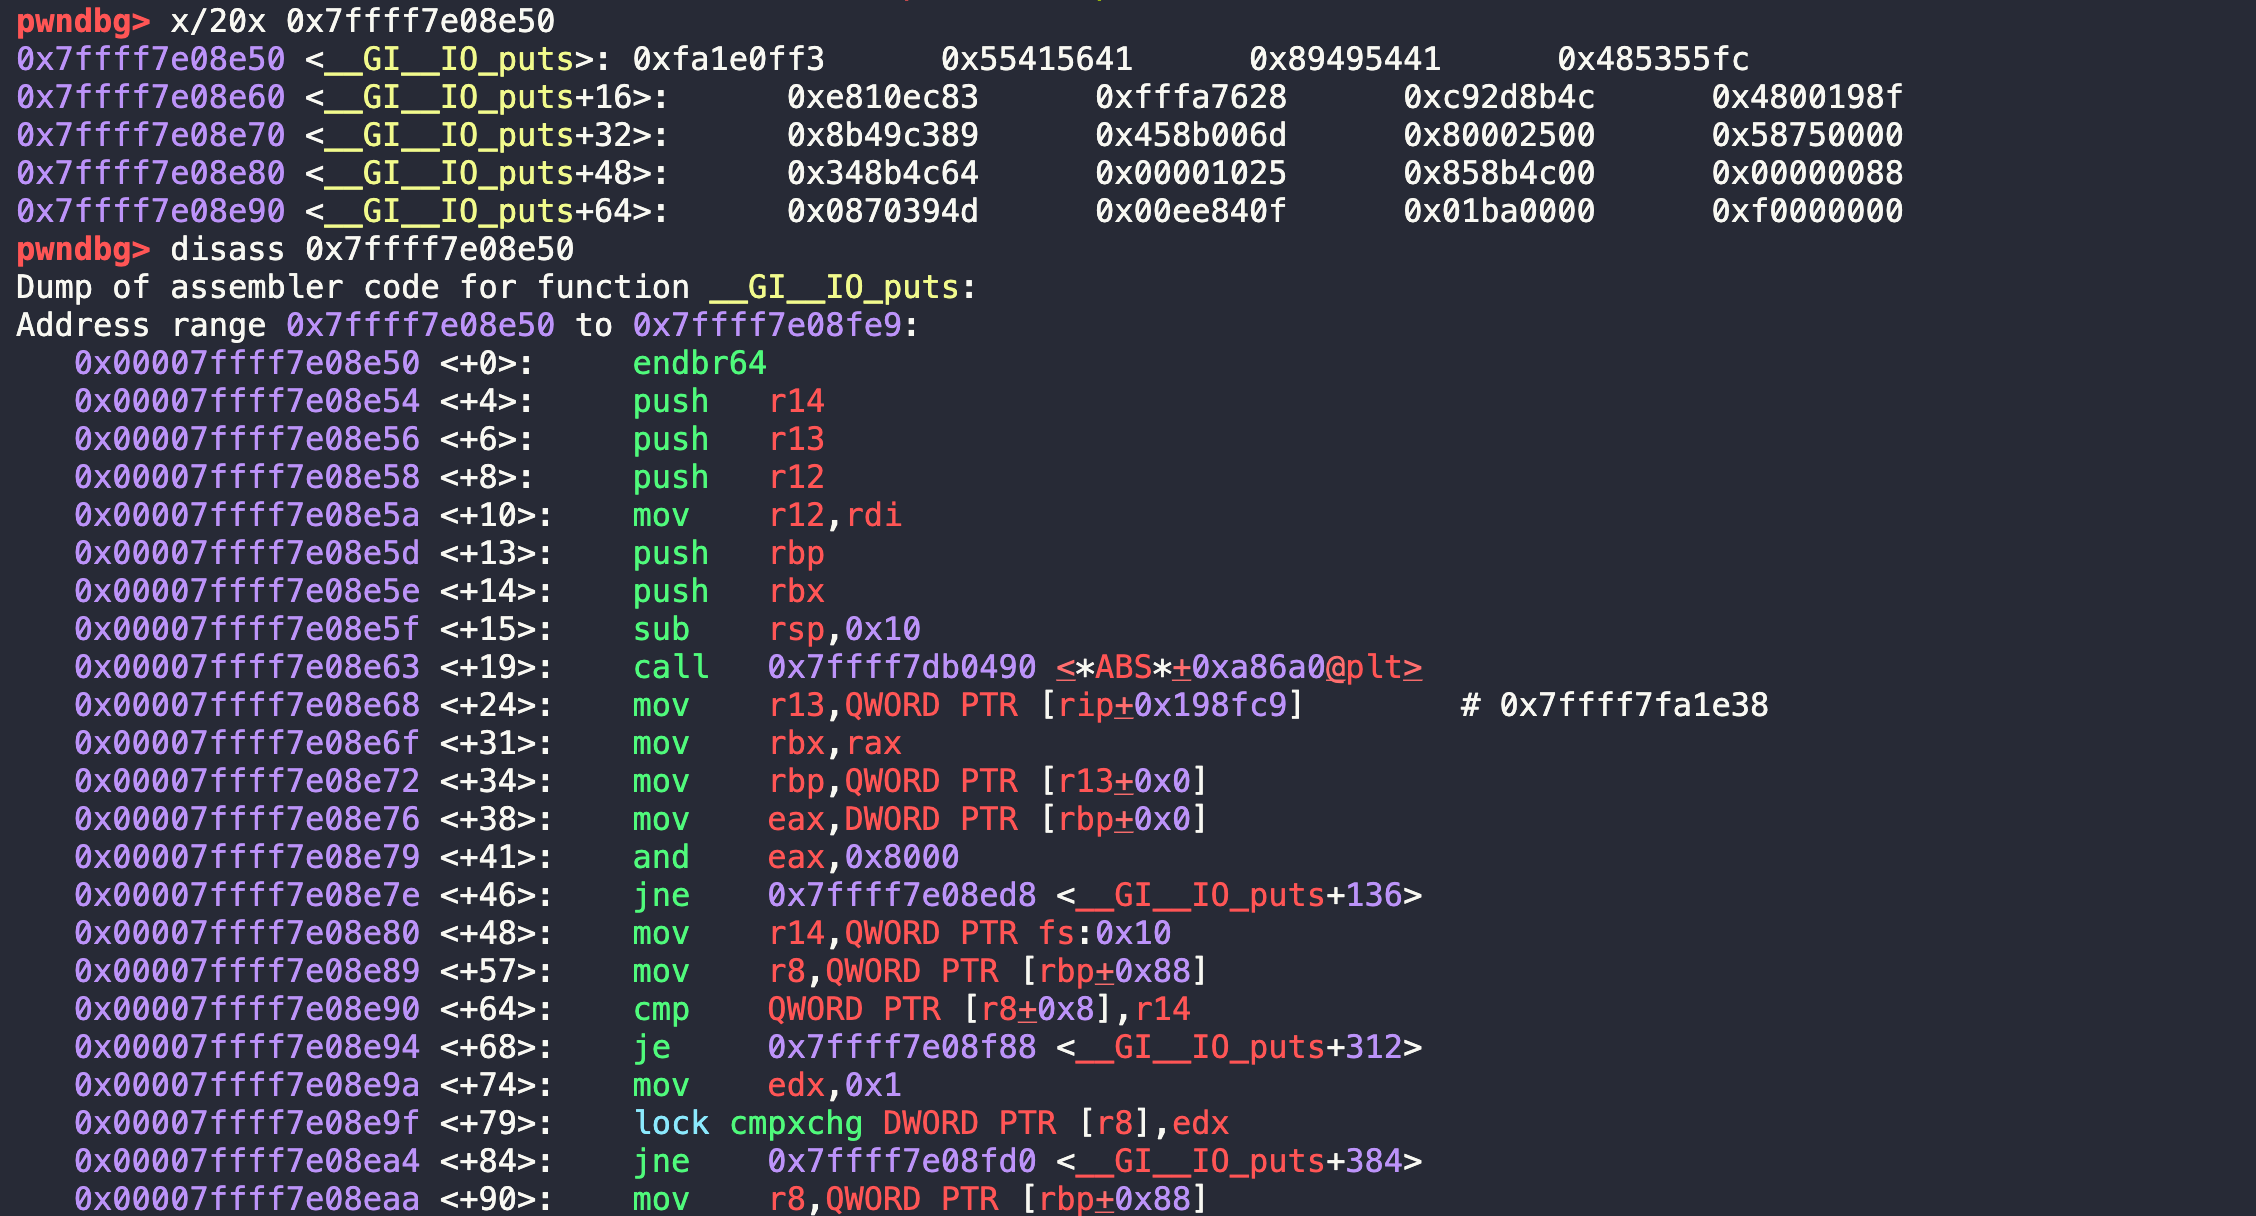
接着查看槽位中读出的目标地址。原截图里是 0x7ffff7e08e50,可用 x/20i 0x7ffff7e08e50 查看指令,或用 disassemble 0x7ffff7e08e50 查看所在函数。这里必须替换成自己读到的地址;x/20x 显示的是十六进制内存单元,并不是反汇编。
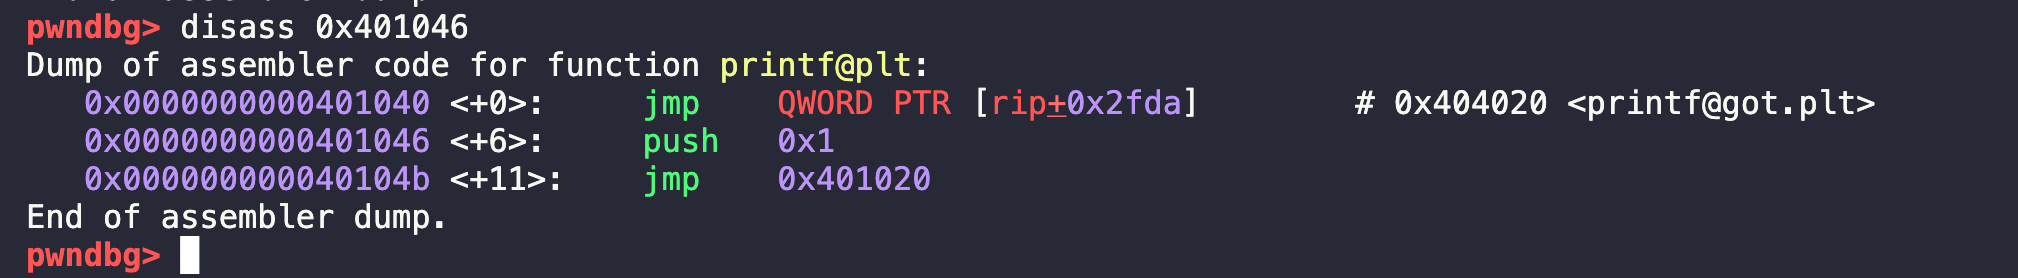
对于还没有写入真实地址的printf,我们也可以看其反汇编的代码disass 0x401046,就是前面IDA pro中的内容。
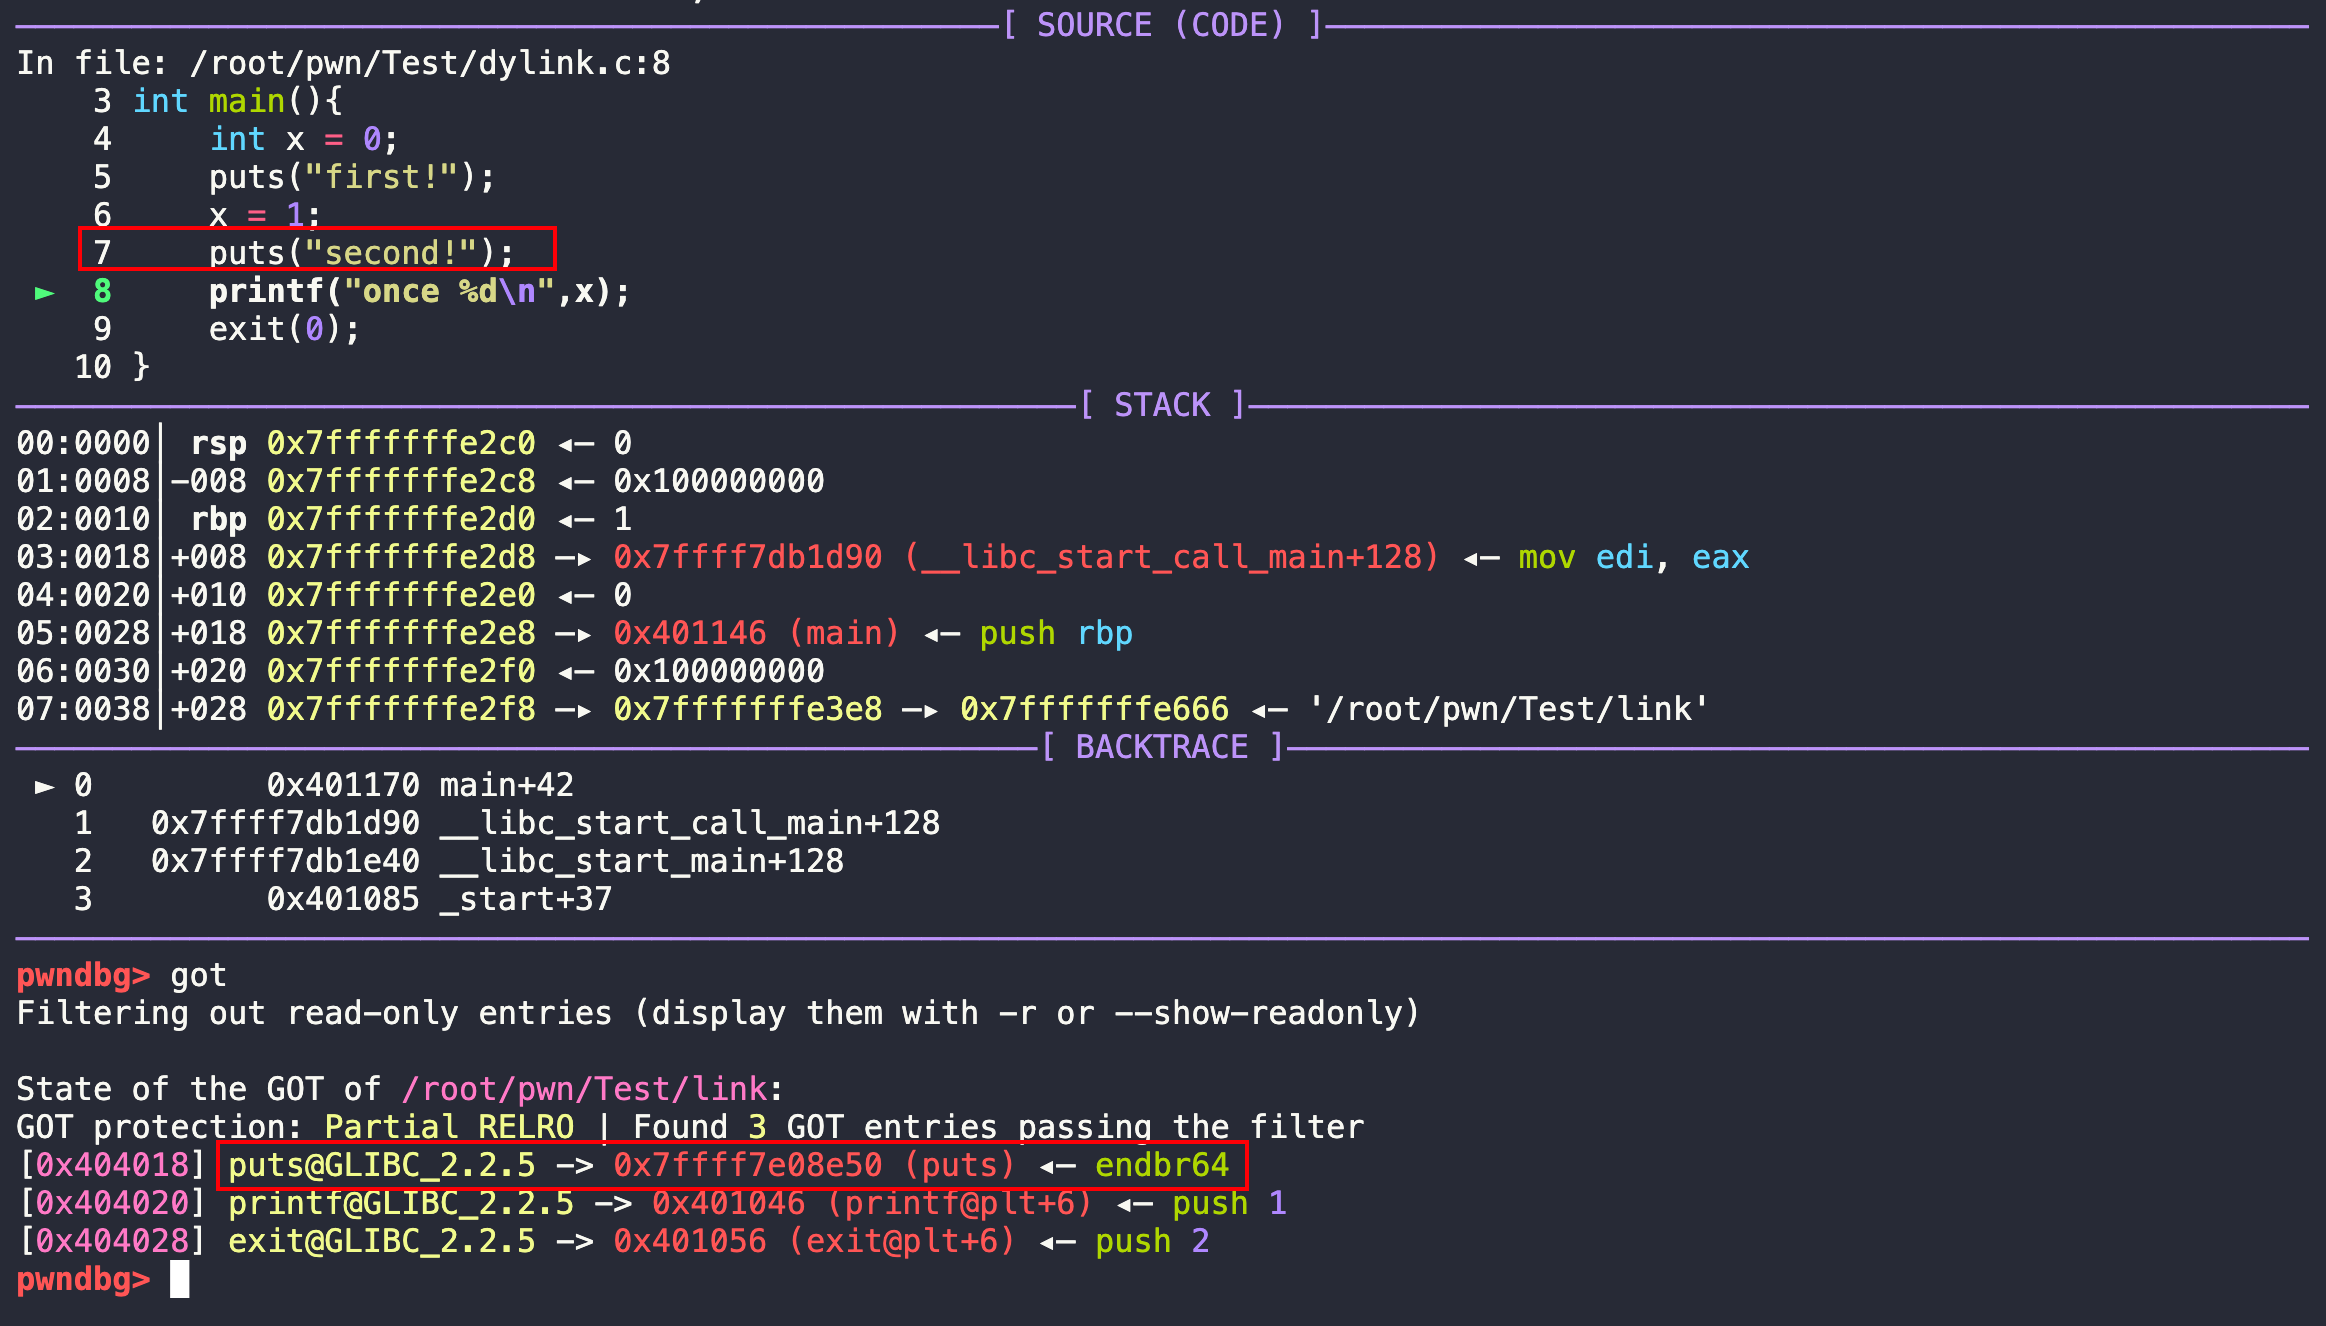
继续执行,执行完了第二个puts。
n,再继续执行。写入了printf的真实地址。
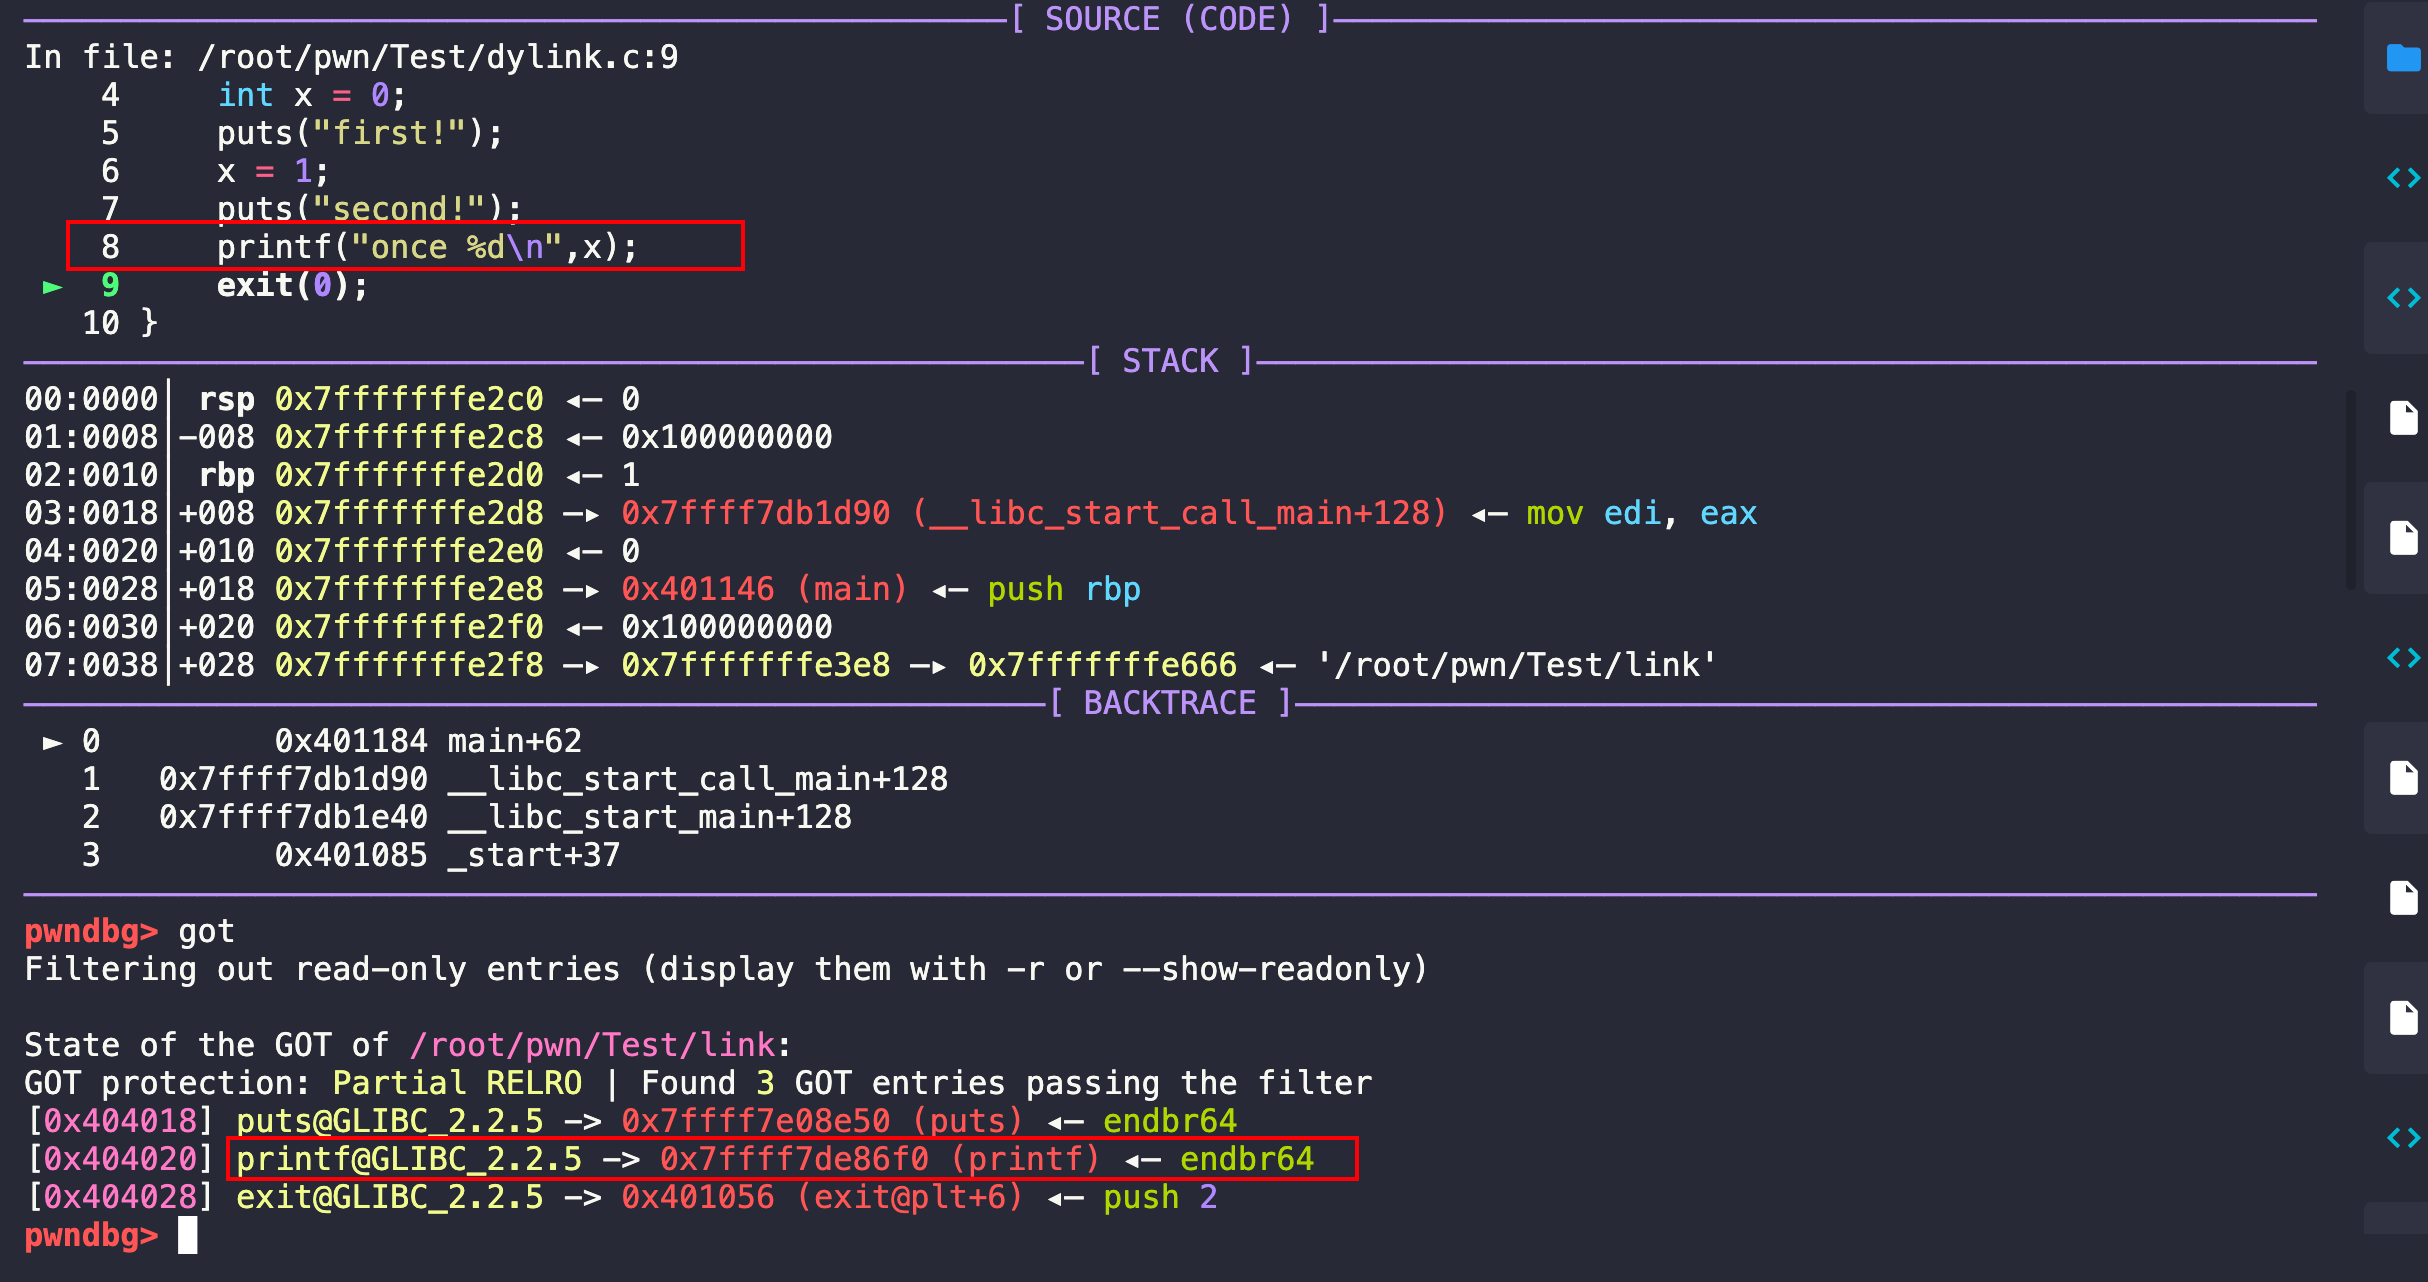
继续用 next 越过 exit(0) 后,程序结束。具体需要几次 next 取决于当前停在哪一行及调试行信息。
参考
【XMCVE 2020 CTF Pwn入门课程】https://www.bilibili.com/video/BV1854y1y7Ro?p=4&vd_source=40fffae7c3c0198962dc9cf9689a1a8a ↩︎
System V gABI:Dynamic Linking,参见 Program Interpreter、Dynamic Linker 和 Dynamic Section。 ↩︎ ↩︎
Linux man-pages:ld.so(8),参见库搜索路径、
LD_BIND_NOW和LD_PRELOAD。 ↩︎ ↩︎GCC:Code Generation Options,参见
-fno-plt。 ↩︎glibc:静态 PIE 自重定位 和 静态启动中的 IFUNC 重定位,参见
apply_irel。 ↩︎https://x2nn.github.io/2025/08/16/pwn基础知识部分/#段segment与节section ↩︎
glibc:x86-64 的 GOT 初始化,参见
elf_machine_runtime_setup。 ↩︎GCC:Instrumentation Options,参见
-fcf-protection。 ↩︎GNU ld:Options,参见
--as-needed、lazy、now、relro、ibtplt和ibt。 ↩︎ ↩︎